

自动驾驶-M2 感知与 BEV-2.3.2 BEVFormer 训练实战代码解读及 Bev 可视化
本节做一个重要的技术决策:不用官方仓库,自己实现精简版—— 理由在下面,这不是偷懒,是在你的硬件上唯一正确的选择。学习课程 端到端自动驾驶实战 | zhijia.dev
我写了一个可视化脚本 vis_bev.py,在测试环境里用随机权重的模型跑通了,示例输出就是上面那张 PNG。不过在看图之前要先说一件事:这次训练其实还没训好,loss 能下降不等于模型学会了。下面按顺序说。
一、先读懂你这次的训练日志
| 现象 | 说明了什么 |
|---|---|
[train] 1 场景, 50 帧,每个 epoch 只有 12 个 batch |
数据非常少。24 个 epoch 加起来只更新了 288 次参数 |
| loss 从 9.25 降到 4.45,到最后一个 epoch 还在匀速往下掉 | 训练没有收敛,只是被提前停了 |
| hm loss 最后约 3.9 | 课程说正常情况下 1–3 个 epoch 就该降到个位数,你这是 24 个 epoch 才勉强到 |
[val] 1 场景, 50 帧,val loss 几乎和 train 一样 |
很可疑:验证集可能和训练集是同一个场景(甚至是同一批帧)。如果是,val loss 就没有参考意义 |
| 显存峰值 6.24GB,每个 epoch 约 3 秒 | 资源完全够用,可以放心多训 |
为什么 loss 降得这么慢:就是上一轮我在 7.1 节说的学习率 bug。OneCycleLR 按 288 步来规划(前 30%,约 86 步用来预热),但代码每个 epoch 才调一次 scheduler.step(),所以总共只走了 24 步,一直停在预热阶段。估算下来,最后一个 epoch 的学习率大约是 4e-5,只有设定峰值 2e-4 的五分之一,后半程的退火阶段一次都没执行。所以 loss 的曲线像一条斜线,而不是先快速下降再趋于平缓。
所以,按你现在这个模型去画图,大概率看到的是:预测热力图很暗,峰值可能都不到 0.3,用默认阈值几乎画不出预测框。 这不代表代码坏了,而是还没训够。可视化脚本正好能帮你直接看到这一点。
二、可视化脚本怎么用
1. 放到服务器上
把 vis_bev.py 放到 ~/carla/work/courses/M2/2.3/,和 train_bev.py 放在同一个目录。它会直接导入你现有的 bev_dataset.py、bev_target.py 和 mini_bevformer.py。
2. 运行
conda activate ad
cd ~/carla/work/courses/M2/2.3

# 先用低阈值,看看模型有没有输出东西
python vis_bev.py --ckpt ./work_dir/best.pth --root ../dataset_v4 \
    --split val --out ./vis --num 20 --score-thr 0.1 --video
模型的配置(BEV 尺寸、层数、图像分辨率)会自动从 checkpoint 里读取,不需要重复填写。
几个可选参数:
| 参数 | 什么时候用 |
|---|---|
--cam-names FRONT,FRONT_LEFT,... |
按你数据集里的相机顺序填写,图上就会显示真实的相机名,不然显示的是 CAM0–5 |
--class-names car,truck,ped,bike |
填你 4 个类别的名字 |
--z-bottom |
如果你的标注里 z 是框底面的高度,而不是中心高度(相机图上的框整体偏高或偏低半个车身时加上) |
--bgr |
如果相机图颜色发蓝(说明 OpenCV 读图时是 BGR 顺序) |
--stride 5 |
每隔 5 帧取一帧 |
3. 服务器没有显示器,怎么看图
任选一种:
- VS Code Remote-SSH:直接在左侧文件树里点开
vis/frame_xxxxx.png。这是最省事的方法。 - 复制到本地:
scp -r leoking@服务器:~/carla/work/courses/M2/2.3/vis ./ - 借用端口转发(你在 1.1 节已经配置过 6006 端口):先停掉 tensorboard,然后运行
python -m http.server 6006 -d vis,在本地浏览器打开http://localhost:6006。
加了 --video 参数后还会生成 vis/bev.mp4,可以连续播放看效果。
三、怎么看懂这张图
每帧输出一张大图,上方是 6 路相机,下方是 4 个鸟瞰图。绿色是真值(GT),红色是预测。
上方:6 路相机图
把 3D 框的 8 个角点用 lidar2img 投影到图像上画出来,用的就是 SCA 里那个投影公式。这一部分其实是在检查数据:如果绿框没有准确框住图里的车,说明标注或相机参数有问题,模型不可能学好。这时候先回去查数据,不要调模型。
下方 4 个鸟瞰面板
① 相机覆盖 + GT 框:对每个 BEV 格子,用和 SCA 完全一样的规则判断它被哪路相机看到,并按相机着色。深色区域是两个相机都能看到的重叠区,白色是哪个相机都看不到的盲区。
- 用途:确认几何关系正确。正前方应该是前相机的颜色,车后方应该是后相机的颜色。课程里说的"99.7% 的格子有覆盖",在这里能直接看到。
- 如果颜色分布是左右颠倒或者前后颠倒的,说明
lidar2img或坐标系约定有问题。
② GT 热力图:encode_targets 画出来的"标准答案",每个物体是一个高斯亮点。
- 用途:对照 ① 里的绿框,亮点必须和框中心对齐。如果对不上(比如镜像了),那就是课程排错表里写的"热力图全是背景"的那个 bug。
③ 预测热力图:模型的输出,经过 sigmoid 后在 4 个类别里取最大值。标题里会显示峰值。
- 训好的模型:GT 的位置会出现亮斑,峰值接近 0.5–0.9。
- 你现在的模型:预计整张图偏暗、几乎均匀,峰值在 0.1–0.3 左右。这就是"还没学会"的直观样子。
④ BEV 特征 PCA + 框对比:送进检测头之前的 BEV 特征是 [256, H, W],每个格子有 256 维,人眼没法看。这里用 PCA 降到 3 维,当成 RGB 颜色显示。颜色相近表示这些格子的特征相近。然后把 GT 框(绿)和解码出来的预测框(红,旁边标注分数)叠加在上面。
在随机权重的示例图里,④ 面板上能看到以自车为中心的 6 条放射状接缝。这些位置正好是两个相机的视野交界处:交界处的格子是两个相机的特征取平均,其他格子只来自一个相机,所以特征明显不同。这就是"SCA 是几何投影 + 平均"的直接体现。训好之后,你应该能在物体所在的位置看到特征的变化,同时也可能看到沿着相机射线方向拉出的"拖影",也就是上一轮讲的深度歧义问题。
终端里的汇总指标
frame   12 | GT   8 | pred   5 | 命中   3 | 热力图峰值 0.412
==== 汇总 ====
Precision 0.600 | Recall 0.375 | 命中框平均中心误差 0.84 m
命中的定义是:类别相同,并且 BEV 平面上的中心距离小于 2 米。这是 nuScenes 检测指标的简化版。
- Precision:预测出来的框里有多少是对的。低说明误检多。
- Recall:真实的物体有多少被找到了。低说明漏检多。
和 loss 不同,这两个数字有直观的含义,比 loss 更能说明模型到底好不好。
四、接下来按这个顺序做
第 1 步:先用现在的模型画一次图(5 分钟)
用上面的命令跑一遍,重点看 ① 和 ②,也就是数据和几何关系对不对。这一步和模型训得好不好无关,如果这里有问题,后面训多久都没用。
第 2 步:修复学习率 bug
在 train_bev.py 中:
# ① train_one_epoch 的参数里加上 scheduler
def train_one_epoch(model, loader, optimizer, scheduler, scaler, device,
                    args, writer, epoch):
    ...
        scaler.step(optimizer)
        scaler.update()
        scheduler.step()                 # ← 每个 batch 调一次
    ...

# ② main 里调用时传进去,并删掉 epoch 循环里的 scheduler.step()
        tr = train_one_epoch(model, train_dl, optimizer, scheduler, scaler,
                             device, args, writer, epoch)
        # scheduler.step()   ← 删掉这一行
顺便在记录 TensorBoard 的地方加一行 writer.add_scalar('train/lr', optimizer.param_groups[1]['lr'], step),这样就能在曲线上直接确认学习率是先升后降的。
第 3 步:做一次"过拟合测试"(判断代码有没有问题的最好方法)
思路是:让模型死记硬背少量数据。如果连训练集都记不住,那一定是代码或数据有 bug。如果能记住,说明整条链路是通的,剩下的问题只是数据量。
你的数据只有 50 帧,每个 epoch 才 3 秒,直接多训几轮:
python train_bev.py --root ../dataset_v4 \
    --epochs 150 --batch-size 4 --bev-size 128 --num-layers 3 \
    --lr 2e-4 --out ./work_dir_overfit
大约 8 分钟就能跑完。然后在训练集上做可视化:
python vis_bev.py --ckpt ./work_dir_overfit/last.pth --root ../dataset_v4 \
--split train --out ./vis_overfit --score-thr 0.3 --video预期结果:hm loss 降到 1 以下,③ 的亮斑和 ② 几乎重合,Recall 在 0.8 以上,红框基本和绿框重叠。
- 做到了:链路没有问题,进入第 4 步。
- 做不到:先看 ① 和 ② 是否对齐,再看相机图里绿框的位置对不对。问题几乎一定出在数据上。
第 4 步:增加数据,并且把训练集和验证集分开
这是决定模型能不能真正学会的关键。50 帧、1 个场景,模型只能把这些画面背下来,换一个场景就不会了。
- 回到 2.1 节,在 CARLA 里多采集几个场景:换地图、换天气、调整交通密度。最好有 5–10 个场景,总共几千帧。
- 训练集和验证集必须是不同的场景。同一个场景里相邻的帧几乎一模一样,用这样的验证集测出来的结果会严重虚高。先看一下
bev_dataset.py是怎么划分 train/val 的。你现在两边都显示"1 场景, 50 帧",很可能是同一份数据。 - 重新训练,这时候 val loss 和验证集上的 Precision/Recall 才真正有意义。
第 5 步:用可视化做对比实验
有了可靠的验证集之后,就可以做课程说的消融实验了。每次改一个变量,用 vis_bev.py 的汇总指标进行对比:
- 每根柱子上的高度点数从 4 改成 8(
num_heights) - 编码器层数 1 层 vs 3 层(验证我上一轮说的"层数多了并不会带来新的图像信息")
- 把 SCA 的平均改成由 query 预测的权重
小结
- 你的训练流程是通的,但因为数据极少,加上学习率 bug,模型还远没有训好,所以现在的图预计比较"暗"。
- 先用
vis_bev.py看 ① 和 ②,确认数据和几何关系没问题。 - 修复
scheduler.step()的位置,然后做 150 个 epoch 的过拟合测试。在训练集上能看到红框和绿框重合,就说明整条链路正确。 - 之后的主要工作是采集更多场景,并把训练集和验证集分开,这才是模型真正能学会的前提。
跑完之后可以把图发给我,我帮你一起看是哪个环节的问题。
代码执行
(ad) leoking@leoking-desktop:~/carla/work/courses/M2/2.3$ python vis_bev.py --ckpt ./work_dir/best.pth --root ../dataset_all \
    --split val --out ./vis --num 20 --score-thr 0.1 --video
[ckpt] epoch=23  val_loss=4.4502  bev=128 layers=3 img=448x256
[val] 2 场景, 4000 帧
frame    0 | GT  15 | pred 100 | 命中   4 | 热力图峰值 0.373
/home/leoking/carla/work/courses/M2/2.3/vis_bev.py:266: UserWarning: Glyph 21069 (\N{CJK UNIFIED IDEOGRAPH-524D}) missing from font(s) DejaVu Sans.
  fig.savefig(save_path, dpi=args.dpi, bbox_inches='tight')
/home/leoking/carla/work/courses/M2/2.3/vis_bev.py:266: UserWarning: Glyph 30456 (\N{CJK UNIFIED IDEOGRAPH-76F8}) missing from font(s) DejaVu Sans.
  fig.savefig(save_path, dpi=args.dpi, bbox_inches='tight')
/home/leoking/carla/work/courses/M2/2.3/vis_bev.py:266: UserWarning: Glyph 26426 (\N{CJK UNIFIED IDEOGRAPH-673A}) missing from font(s) DejaVu Sans.
  fig.savefig(save_path, dpi=args.dpi, bbox_inches='tight')
/home/leoking/carla/work/courses/M2/2.3/vis_bev.py:266: UserWarning: Glyph 35206 (\N{CJK UNIFIED IDEOGRAPH-8986}) missing from font(s) DejaVu Sans.
  fig.savefig(save_path, dpi=args.dpi, bbox_inches='tight')
/home/leoking/carla/work/courses/M2/2.3/vis_bev.py:266: UserWarning: Glyph 30422 (\N{CJK UNIFIED IDEOGRAPH-76D6}) missing from font(s) DejaVu Sans.
  fig.savefig(save_path, dpi=args.dpi, bbox_inches='tight')
/home/leoking/carla/work/courses/M2/2.3/vis_bev.py:266: UserWarning: Glyph 26694 (\N{CJK UNIFIED IDEOGRAPH-6846}) missing from font(s) DejaVu Sans.
  fig.savefig(save_path, dpi=args.dpi, bbox_inches='tight')
/home/leoking/carla/work/courses/M2/2.3/vis_bev.py:266: UserWarning: Glyph 20010 (\N{CJK UNIFIED IDEOGRAPH-4E2A}) missing from font(s) DejaVu Sans.
  fig.savefig(save_path, dpi=args.dpi, bbox_inches='tight')
/home/leoking/carla/work/courses/M2/2.3/vis_bev.py:266: UserWarning: Glyph 28145 (\N{CJK UNIFIED IDEOGRAPH-6DF1}) missing from font(s) DejaVu Sans.
  fig.savefig(save_path, dpi=args.dpi, bbox_inches='tight')
/home/leoking/carla/work/courses/M2/2.3/vis_bev.py:266: UserWarning: Glyph 33394 (\N{CJK UNIFIED IDEOGRAPH-8272}) missing from font(s) DejaVu Sans.
  fig.savefig(save_path, dpi=args.dpi, bbox_inches='tight')
/home/leoking/carla/work/courses/M2/2.3/vis_bev.py:266: UserWarning: Glyph 22810 (\N{CJK UNIFIED IDEOGRAPH-591A}) missing from font(s) DejaVu Sans.
  fig.savefig(save_path, dpi=args.dpi, bbox_inches='tight')
/home/leoking/carla/work/courses/M2/2.3/vis_bev.py:266: UserWarning: Glyph 37325 (\N{CJK UNIFIED IDEOGRAPH-91CD}) missing from font(s) DejaVu Sans.
  fig.savefig(save_path, dpi=args.dpi, bbox_inches='tight')
/home/leoking/carla/work/courses/M2/2.3/vis_bev.py:266: UserWarning: Glyph 21472 (\N{CJK UNIFIED IDEOGRAPH-53E0}) missing from font(s) DejaVu Sans.
  fig.savefig(save_path, dpi=args.dpi, bbox_inches='tight')
/home/leoking/carla/work/courses/M2/2.3/vis_bev.py:266: UserWarning: Glyph 30333 (\N{CJK UNIFIED IDEOGRAPH-767D}) missing from font(s) DejaVu Sans.
  fig.savefig(save_path, dpi=args.dpi, bbox_inches='tight')
/home/leoking/carla/work/courses/M2/2.3/vis_bev.py:266: UserWarning: Glyph 26080 (\N{CJK UNIFIED IDEOGRAPH-65E0}) missing from font(s) DejaVu Sans.
  fig.savefig(save_path, dpi=args.dpi, bbox_inches='tight')
/home/leoking/carla/work/courses/M2/2.3/vis_bev.py:266: UserWarning: Glyph 21491 (\N{CJK UNIFIED IDEOGRAPH-53F3}) missing from font(s) DejaVu Sans.
  fig.savefig(save_path, dpi=args.dpi, bbox_inches='tight')
/home/leoking/carla/work/courses/M2/2.3/vis_bev.py:266: UserWarning: Glyph 28909 (\N{CJK UNIFIED IDEOGRAPH-70ED}) missing from font(s) DejaVu Sans.
  fig.savefig(save_path, dpi=args.dpi, bbox_inches='tight')
/home/leoking/carla/work/courses/M2/2.3/vis_bev.py:266: UserWarning: Glyph 21147 (\N{CJK UNIFIED IDEOGRAPH-529B}) missing from font(s) DejaVu Sans.
  fig.savefig(save_path, dpi=args.dpi, bbox_inches='tight')
/home/leoking/carla/work/courses/M2/2.3/vis_bev.py:266: UserWarning: Glyph 22270 (\N{CJK UNIFIED IDEOGRAPH-56FE}) missing from font(s) DejaVu Sans.
  fig.savefig(save_path, dpi=args.dpi, bbox_inches='tight')
/home/leoking/carla/work/courses/M2/2.3/vis_bev.py:266: UserWarning: Glyph 65288 (\N{FULLWIDTH LEFT PARENTHESIS}) missing from font(s) DejaVu Sans.
  fig.savefig(save_path, dpi=args.dpi, bbox_inches='tight')
/home/leoking/carla/work/courses/M2/2.3/vis_bev.py:266: UserWarning: Glyph 35757 (\N{CJK UNIFIED IDEOGRAPH-8BAD}) missing from font(s) DejaVu Sans.
  fig.savefig(save_path, dpi=args.dpi, bbox_inches='tight')
/home/leoking/carla/work/courses/M2/2.3/vis_bev.py:266: UserWarning: Glyph 32451 (\N{CJK UNIFIED IDEOGRAPH-7EC3}) missing from font(s) DejaVu Sans.
  fig.savefig(save_path, dpi=args.dpi, bbox_inches='tight')
/home/leoking/carla/work/courses/M2/2.3/vis_bev.py:266: UserWarning: Glyph 30446 (\N{CJK UNIFIED IDEOGRAPH-76EE}) missing from font(s) DejaVu Sans.
  fig.savefig(save_path, dpi=args.dpi, bbox_inches='tight')
/home/leoking/carla/work/courses/M2/2.3/vis_bev.py:266: UserWarning: Glyph 26631 (\N{CJK UNIFIED IDEOGRAPH-6807}) missing from font(s) DejaVu Sans.
  fig.savefig(save_path, dpi=args.dpi, bbox_inches='tight')
/home/leoking/carla/work/courses/M2/2.3/vis_bev.py:266: UserWarning: Glyph 65289 (\N{FULLWIDTH RIGHT PARENTHESIS}) missing from font(s) DejaVu Sans.
  fig.savefig(save_path, dpi=args.dpi, bbox_inches='tight')
/home/leoking/carla/work/courses/M2/2.3/vis_bev.py:266: UserWarning: Glyph 39044 (\N{CJK UNIFIED IDEOGRAPH-9884}) missing from font(s) DejaVu Sans.
  fig.savefig(save_path, dpi=args.dpi, bbox_inches='tight')
/home/leoking/carla/work/courses/M2/2.3/vis_bev.py:266: UserWarning: Glyph 27979 (\N{CJK UNIFIED IDEOGRAPH-6D4B}) missing from font(s) DejaVu Sans.
  fig.savefig(save_path, dpi=args.dpi, bbox_inches='tight')
/home/leoking/carla/work/courses/M2/2.3/vis_bev.py:266: UserWarning: Glyph 23792 (\N{CJK UNIFIED IDEOGRAPH-5CF0}) missing from font(s) DejaVu Sans.
  fig.savefig(save_path, dpi=args.dpi, bbox_inches='tight')
/home/leoking/carla/work/courses/M2/2.3/vis_bev.py:266: UserWarning: Glyph 20540 (\N{CJK UNIFIED IDEOGRAPH-503C}) missing from font(s) DejaVu Sans.
  fig.savefig(save_path, dpi=args.dpi, bbox_inches='tight')
/home/leoking/carla/work/courses/M2/2.3/vis_bev.py:266: UserWarning: Glyph 29305 (\N{CJK UNIFIED IDEOGRAPH-7279}) missing from font(s) DejaVu Sans.
  fig.savefig(save_path, dpi=args.dpi, bbox_inches='tight')
/home/leoking/carla/work/courses/M2/2.3/vis_bev.py:266: UserWarning: Glyph 24449 (\N{CJK UNIFIED IDEOGRAPH-5F81}) missing from font(s) DejaVu Sans.
  fig.savefig(save_path, dpi=args.dpi, bbox_inches='tight')
/home/leoking/carla/work/courses/M2/2.3/vis_bev.py:266: UserWarning: Glyph 32511 (\N{CJK UNIFIED IDEOGRAPH-7EFF}) missing from font(s) DejaVu Sans.
  fig.savefig(save_path, dpi=args.dpi, bbox_inches='tight')
/home/leoking/carla/work/courses/M2/2.3/vis_bev.py:266: UserWarning: Glyph 32418 (\N{CJK UNIFIED IDEOGRAPH-7EA2}) missing from font(s) DejaVu Sans.
  fig.savefig(save_path, dpi=args.dpi, bbox_inches='tight')
/home/leoking/carla/work/courses/M2/2.3/vis_bev.py:266: UserWarning: Glyph 21629 (\N{CJK UNIFIED IDEOGRAPH-547D}) missing from font(s) DejaVu Sans.
  fig.savefig(save_path, dpi=args.dpi, bbox_inches='tight')
/home/leoking/carla/work/courses/M2/2.3/vis_bev.py:266: UserWarning: Glyph 20013 (\N{CJK UNIFIED IDEOGRAPH-4E2D}) missing from font(s) DejaVu Sans.
  fig.savefig(save_path, dpi=args.dpi, bbox_inches='tight')
/home/leoking/carla/work/courses/M2/2.3/vis_bev.py:266: UserWarning: Glyph 21516 (\N{CJK UNIFIED IDEOGRAPH-540C}) missing from font(s) DejaVu Sans.
  fig.savefig(save_path, dpi=args.dpi, bbox_inches='tight')
/home/leoking/carla/work/courses/M2/2.3/vis_bev.py:266: UserWarning: Glyph 31867 (\N{CJK UNIFIED IDEOGRAPH-7C7B}) missing from font(s) DejaVu Sans.
  fig.savefig(save_path, dpi=args.dpi, bbox_inches='tight')
/home/leoking/carla/work/courses/M2/2.3/vis_bev.py:266: UserWarning: Glyph 24515 (\N{CJK UNIFIED IDEOGRAPH-5FC3}) missing from font(s) DejaVu Sans.
  fig.savefig(save_path, dpi=args.dpi, bbox_inches='tight')
/home/leoking/carla/work/courses/M2/2.3/vis_bev.py:266: UserWarning: Glyph 36317 (\N{CJK UNIFIED IDEOGRAPH-8DDD}) missing from font(s) DejaVu Sans.
  fig.savefig(save_path, dpi=args.dpi, bbox_inches='tight')
/home/leoking/carla/work/courses/M2/2.3/vis_bev.py:266: UserWarning: Glyph 38408 (\N{CJK UNIFIED IDEOGRAPH-9608}) missing from font(s) DejaVu Sans.
  fig.savefig(save_path, dpi=args.dpi, bbox_inches='tight')
frame    1 | GT  15 | pred 100 | 命中   5 | 热力图峰值 0.380
frame    2 | GT  14 | pred 100 | 命中   6 | 热力图峰值 0.389
frame    3 | GT  14 | pred 100 | 命中   5 | 热力图峰值 0.385
frame    4 | GT  15 | pred 100 | 命中   4 | 热力图峰值 0.383
frame    5 | GT  15 | pred 100 | 命中   4 | 热力图峰值 0.377
frame    6 | GT  17 | pred 100 | 命中   5 | 热力图峰值 0.381
frame    7 | GT  16 | pred 100 | 命中   4 | 热力图峰值 0.390
frame    8 | GT  16 | pred 100 | 命中   6 | 热力图峰值 0.390
frame    9 | GT  17 | pred 100 | 命中   5 | 热力图峰值 0.388
frame   10 | GT  15 | pred 100 | 命中   5 | 热力图峰值 0.386
frame   11 | GT  15 | pred 100 | 命中   3 | 热力图峰值 0.383
frame   12 | GT  15 | pred 100 | 命中   4 | 热力图峰值 0.381
frame   13 | GT  16 | pred 100 | 命中   3 | 热力图峰值 0.381
frame   14 | GT  15 | pred 100 | 命中   3 | 热力图峰值 0.382
frame   15 | GT  17 | pred 100 | 命中   4 | 热力图峰值 0.373
frame   16 | GT  17 | pred 100 | 命中   4 | 热力图峰值 0.378
frame   17 | GT  17 | pred 100 | 命中   4 | 热力图峰值 0.378
frame   18 | GT  14 | pred 100 | 命中   4 | 热力图峰值 0.380
frame   19 | GT  15 | pred 100 | 命中   4 | 热力图峰值 0.373

==== 汇总 ====
帧数 20 | GT 310 | 预测 2000 | 命中 86
Precision 0.043 | Recall 0.277 | 命中框平均中心误差 1.28 m
图片保存在 /home/leoking/carla/work/courses/M2/2.3/vis
没装 imageio,可用: ffmpeg -framerate 5 -pattern_type glob -i './vis/frame_*.png' -pix_fmt yuv420p bev.mp4
(ad) leoking@leoking-desktop:~/carla/work/courses/M2/2.3$ 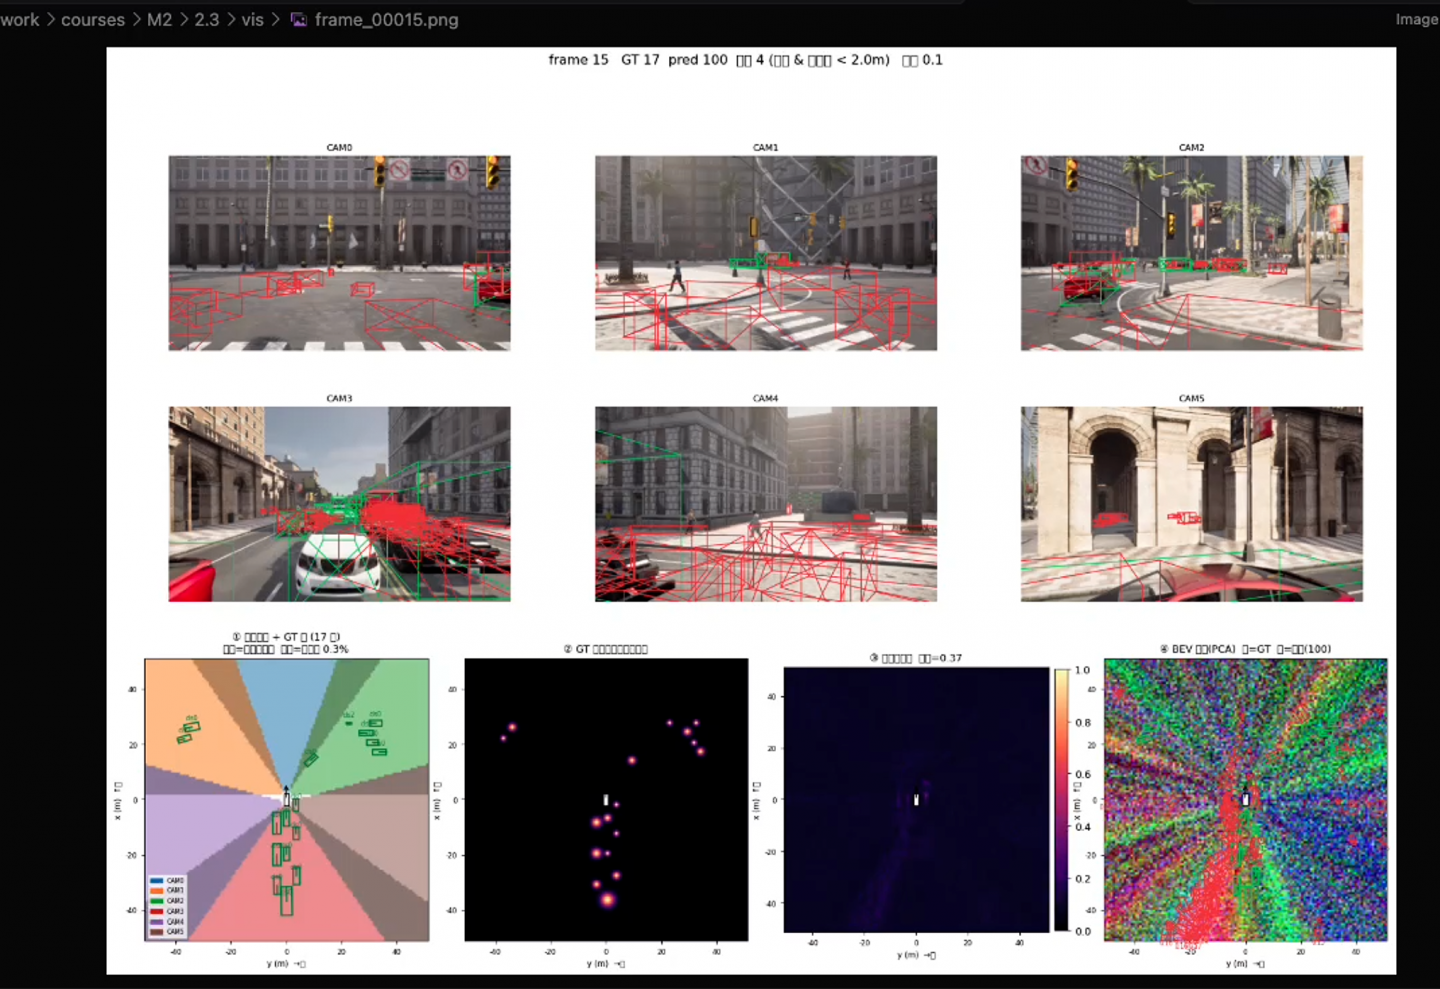
问题分析
I removed the with torch.no_grad(): line by mistake, so I'm putting it back.
结论分两部分:数据和几何是对的,可以放心往下做;模型还没学会,和上次的预判一致。下面逐块说明我是怎么看出来的,以及接下来做什么。
一、数据和几何:基本正常
这一部分最重要。如果这里有问题,后面训多久都没用。
1. 面板 ①(相机覆盖):正常
- 6 个扇区围成一圈,盲区只有 0.3%,和课程说的"99.7% 有覆盖"完全一致。
- 从颜色可以读出你的相机顺序:蓝色朝正前方,橙色在左前,绿色在右前,红色朝正后方,紫色在左后,棕色在右后。也就是:
CAM0=前,CAM1=左前,CAM2=右前,CAM3=后,CAM4=左后,CAM5=右后。
以后运行时加上--cam-names FRONT,FRONT_LEFT,FRONT_RIGHT,BACK,BACK_LEFT,BACK_RIGHT,图上就会显示真实的相机名。 - 盲区是自车左右两侧紧贴车身的一条窄带。这是因为侧面没有朝正左、正右方向的相机,属于正常现象。
2. 面板 ① 的 GT 框和相机图互相印证:正常
把鸟瞰图里的框和相机画面一一对照:
| BEV 上的 GT 框 | 对应的相机画面 |
|---|---|
| 自车正后方一长串纵向排列的框(x 从 -5 到 -45) | CAM3(后)里能看到同车道后面排着一串车,白车上有绿框 |
| 右前方(x≈20–25,y≈30)一组横向的框 | CAM2(右前)画面右侧远处有一排小绿框,是横穿路口的车流 |
| 右前方贴近自车的一个斜框 | CAM0 右边缘和 CAM2 左边缘都能看到那辆红车,上面有绿框 |
方位、朝向(后方车流是纵向的,路口车流是横向的)、数量都能对上,说明 lidar2img 和标注的坐标系是一致的。
3. 面板 ② 的 GT 热力图和面板 ① 的框位置一一对应:正常
每个亮点都落在面板 ① 中相应框的中心。这说明 encode_targets 的行列计算和 _make_coords 是一致的,课程排错表里那个"热力图全是背景"的 bug 不存在。大车的光斑更大(后方最远那个最明显),说明高斯半径随物体尺寸变化的逻辑也生效了。
4. 几个看起来奇怪、其实不是问题的地方
- CAM4、CAM5 里有横穿画面的绿色长斜线:这是贴近相机的那辆车(自车右后方)的框,有的角点离相机不到 1 米。透视除法把这些点拉到了很远的地方,所以线会被拉得很长。这是画图方式造成的,不是数据错误。新版脚本里已经跳过了这类线段。
- CAM3、CAM5 画面底部有红色车身:可能是自车本身或者紧贴的那辆车出现在镜头里。新版脚本会自动检查 GT 里有没有混入自车(中心落在原点附近的框),如果有会在终端打印 ⚠。你重新跑一次看看有没有这个警告。
二、模型:还没学会(符合预期)
1. 面板 ③(预测热力图):几乎全黑
峰值 0.39,确实比初始值 0.1 高,说明模型学到了一点东西。但整张图没有任何和面板 ② 对得上的亮斑。也就是说,模型还不能在图像里"找到"物体。
2. 标题里的数字:“命中 6” 有很大水分
GT 16 | pred 100 | 命中 6 | 阈值 0.1- pred 正好是 100,这是
topk的上限,不是模型真的预测出了 100 个物体。阈值 0.1 太低,基本等于初始值,大量背景格子都超过了它。 - 精确率只有 6/100 = 6%。在 100 个分散的点里,有几个刚好落在 2 米范围内,靠的很大程度是运气和位置记忆(见下一点)。
3. 面板 ④(BEV 特征 PCA):两个现象都值得注意
① 满屏都是椒盐状的噪点。 相邻格子的特征完全不相关,说明 BEV 特征里占主导的仍然是每个格子各自随机初始化的 bev_embedding,从图像采样回来的信息很弱。只更新了 288 次,加上学习率只有设定值的几分之一,这些随机向量几乎还是原样。相邻格子的特征都不连续,热力图自然也形成不了平滑的光斑。
② 后方扇区出现了一块明显的红色楔形,红色预测框也密集分布在这一带。 这个位置正好是 CAM3 拍到的那串车。有两种可能:
- 好的解释:后视相机的图像特征确实开始起作用了。
- 不好的解释:你只有 1 个场景、50 帧,后方车队在这 50 帧里一直在同一个位置。模型可能只是靠
bev_embedding背下了"后面那几格常常有车",根本没在看图像。
要区分这两种情况,我在脚本里加了一个对照实验参数 --blank-test,把输入图像全部换成 0:
python vis_bev.py --ckpt ./work_dir/best.pth --root ../dataset_v4 \
--split val --out ./vis_blank --num 20 --score-thr 0.1 --blank-test- 如果看不到图像的时候热力图形状和命中数几乎不变,说明模型在背位置,图像分支基本没用上。
- 如果命中数明显下降,说明模型确实在利用图像。
这个测试以后也很有用:每次训练完都跑一遍,就能判断模型到底是在"看图"还是在"背题"。
4. 相机图上红框满屏
红框满屏是因为 100 个低分预测都被画上去了,而且尺寸普遍偏大(reg loss 还在 2.3,尺寸还没学好)。新版脚本中,相机图只画分数 ≥ 0.3 的预测(参数 --cam-score-thr),鸟瞰图仍然按 --score-thr 显示全部预测,画面会清爽很多。
三、顺手修复:中文显示成方块
图里中文变成 □□,是因为服务器上没有中文字体。新版脚本会自动搜索系统里的中文字体。如果找不到,会在终端提示你,按下面两种方法之一处理:
# 方法 1:有 sudo 权限
sudo apt install fonts-noto-cjk
rm -rf ~/.cache/matplotlib     # 清除 matplotlib 的字体缓存,必须做

# 方法 2:没有 sudo 权限,把任意中文字体文件(比如 Windows 的 msyh.ttc、
#         或者下载的 NotoSansSC-Regular.otf)放到服务器上,然后指定路径
python vis_bev.py ... --font ~/fonts/NotoSansSC-Regular.otf
四、下一步(顺序不变,现在可以确定数据没问题了)
- 用新版脚本覆盖旧文件,加上
--blank-test跑一次对照,记下两次的命中数。 - 修复学习率 bug:把
scheduler.step()移到每个 batch 之后(上一条回复的第 2 步)。 - 做 150 个 epoch 的过拟合测试,然后在训练集上画图:
python train_bev.py --root ../dataset_v4 --epochs 150 --batch-size 4 \ --bev-size 128 --num-layers 3 --out ./work_dir_overfit python vis_bev.py --ckpt ./work_dir_overfit/last.pth --root ../dataset_v4 \ --split train --out ./vis_overfit --score-thr 0.3 \ --cam-names FRONT,FRONT_LEFT,FRONT_RIGHT,BACK,BACK_LEFT,BACK_RIGHT合格的标准:面板 ③ 的亮斑和面板 ② 基本重合,面板 ④ 的噪点明显变平滑,物体位置出现色块;pred 数量接近 GT(不再是 100),Recall 在 0.8 以上。
- 过拟合测试通过之后,多采集几个场景,并把训练集和验证集按场景分开。这一步也能解决"背位置"的问题:场景一多,
bev_embedding就没法靠记位置来蒙对了。
用新版 vis_bev.py 替换旧文件就可以。跑完过拟合测试后,可以把训练集和 --blank-test 两张图一起发给我对比。
vis_bev.py 代码:
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""
vis_bev.py —— MiniBEVFormer 推理 + 鸟瞰图可视化

每帧输出一张大图:
  上面两行:6 路相机原图,叠加 GT 框(绿)和预测框(红)的 3D 投影
  下面一行 4 个 BEV 面板:
    ① 相机覆盖 + GT 框      —— 每个 BEV 格子被哪路相机看到(检查几何)
    ② GT 热力图             —— encode_targets 画出来的"标准答案"
    ③ 预测热力图            —— 模型输出 sigmoid 后
    ④ BEV 特征 PCA + 框对比 —— 256 维 BEV 特征降到 3 维当 RGB,叠加 GT/预测框

用法(放在 2.3 目录下,和 train_bev.py 同级):
  python vis_bev.py --ckpt ./work_dir/best.pth --root ../dataset_v4 \
      --split val --out ./vis --num 20 --score-thr 0.3
  # 加 --video 会额外把所有帧合成 mp4/gif
"""

import argparse
import os

import numpy as np
import torch
import torch.nn.functional as F
from torch.utils.data import DataLoader

import matplotlib
matplotlib.use('Agg')                      # 服务器无显示器,直接存图
import matplotlib.pyplot as plt
from matplotlib.gridspec import GridSpec
from matplotlib.patches import Polygon, Patch

from bev_dataset import BEVDataset, bev_collate_fn
from bev_target import encode_targets
from mini_bevformer import MiniBEVFormer

GT_COLOR, PRED_COLOR = '#22c55e', '#ef4444'

# ==================== 解码:热力图 → 3D 框 ====================
@torch.no_grad()
def decode(out, pc_range, score_thr=0.3, topk=100):
    """
    out['heatmap'] [1,C,H,W] (logits), out['reg'] [1,8,H,W]
    返回 boxes [K,7] (x,y,z,l,w,h,yaw), scores [K], labels [K]
    —— 每一步都是 encode_targets 的逆运算
    """
    hm = torch.sigmoid(out['heatmap'][0].float())        # [C,H,W]
    reg = out['reg'][0].float()                          # [8,H,W]
    C, H, W = hm.shape
    voxel = 2 * pc_range / H

    # 3×3 局部最大值 = 简易 NMS(CenterPoint 不需要传统 NMS 的原因)
    peak = hm == F.max_pool2d(hm[None], 3, 1, 1)[0]
    hm = hm * peak

    scores, idx = hm.flatten().topk(min(topk, hm.numel()))
    keep = scores > score_thr
    scores, idx = scores[keep], idx[keep]
    labels = idx // (H * W)
    pix = idx % (H * W)
    row, col = pix // W, pix % W

    r = reg[:, row, col]                                  # [8,K]
    x = pc_range - (row.float() + r[1]) * voxel           # row_f = (pc - x)/voxel
    y = (col.float() + r[0]) * voxel - pc_range           # col_f = (y + pc)/voxel
    z = r[2]
    l, w, h = r[3].exp(), r[4].exp(), r[5].exp()
    yaw = torch.atan2(r[6], r[7])
    boxes = torch.stack([x, y, z, l, w, h, yaw], dim=1)
    return boxes.cpu().numpy(), scores.cpu().numpy(), labels.cpu().numpy()

# ==================== 几何工具 ====================
def box_corners_bev(box):
    """(x,y,...,yaw) → BEV 平面 4 个角点 [4,2],列为 (x,y);前两个是车头"""
    x, y, _, l, w, _, yaw = box[:7]
    c, s = np.cos(yaw), np.sin(yaw)
    local = np.array([[l/2, w/2], [l/2, -w/2], [-l/2, -w/2], [-l/2, w/2]])
    R = np.array([[c, -s], [s, c]])
    return local @ R.T + np.array([x, y])

def box_corners_3d(box, z_is_bottom=False):
    """8 个 3D 角点 [8,3]:前 4 个底面,后 4 个顶面"""
    x, y, z, l, w, h, yaw = box[:7]
    bev = box_corners_bev(box)
    z0 = z if z_is_bottom else z - h / 2
    bottom = np.c_[bev, np.full(4, z0)]
    top = np.c_[bev, np.full(4, z0 + h)]
    return np.vstack([bottom, top])

EDGES = [(0, 1), (1, 2), (2, 3), (3, 0), (4, 5), (5, 6), (6, 7), (7, 4),
         (0, 4), (1, 5), (2, 6), (3, 7), (0, 5), (1, 4)]   # 最后两条叉 = 车头面

def project(pts3d, l2i):
    """[P,3] 自车系 → 像素 [P,2] 和深度 [P](与 SCA 里的投影公式相同)"""
    ph = np.c_[pts3d, np.ones(len(pts3d))] @ l2i.T
    d = ph[:, 2]
    uv = ph[:, :2] / np.clip(d, 1e-5, None)[:, None]
    return uv, d

def camera_coverage(l2i_all, bev_coords, img_w, img_h, zs=(-2.0, 0.0, 2.0, 4.0)):
    """
    与 SpatialCrossAttention 完全相同的有效性判断:
    返回 [N, X*Y] bool —— 第 n 路相机是否能看到该格子(任一高度点有效即可)
    """
    N = l2i_all.shape[0]
    P = bev_coords.shape[0]
    cov = np.zeros((N, P), bool)
    for z in zs:
        pts = np.c_[bev_coords, np.full(P, z)]
        for n in range(N):
            uv, d = project(pts, l2i_all[n])
            cov[n] |= ((d > 1e-5) & (uv[:, 0] > 0) & (uv[:, 0] < img_w)
                       & (uv[:, 1] > 0) & (uv[:, 1] < img_h))
    return cov

def to_rgb(img, bgr=False):
    """把网络输入的 [3,H,W] 张量还原成可显示的 [H,W,3]"""
    x = img.float().cpu().numpy().transpose(1, 2, 0)
    if x.min() < -0.1:                         # 像是做过 ImageNet 归一化
        x = x * np.array([0.229, 0.224, 0.225]) + np.array([0.485, 0.456, 0.406])
    elif x.max() > 1.5:                         # 0-255
        x = x / 255.0
    if bgr:
        x = x[..., ::-1]
    return np.clip(x, 0, 1)

def pca_rgb(feat):
    """BEV 特征 [C,H,W] → PCA 前 3 主成分 → [H,W,3]"""
    C, H, W = feat.shape
    X = feat.float().reshape(C, -1).T.cpu()             # [HW,C]
    X = X - X.mean(0, keepdim=True)
    _, _, V = torch.pca_lowrank(X, q=3, center=False)
    Y = (X @ V[:, :3]).numpy()
    lo, hi = np.percentile(Y, 2, axis=0), np.percentile(Y, 98, axis=0)
    Y = np.clip((Y - lo) / (hi - lo + 1e-6), 0, 1)
    return Y.reshape(H, W, 3)

# ==================== 简易指标(中心距离匹配)====================
def match(gt_boxes, gt_labels, pr_boxes, pr_labels, dist_thr=2.0):
    """同类别、BEV 中心距离 < dist_thr 米算命中(nuScenes 检测指标的简化版)"""
    used = np.zeros(len(pr_boxes), bool)
    tp, errs = 0, []
    for g, gl in zip(gt_boxes, gt_labels):
        best, bi = dist_thr, -1
        for i, (p, pl) in enumerate(zip(pr_boxes, pr_labels)):
            if used[i] or pl != gl:
                continue
            d = np.hypot(g[0] - p[0], g[1] - p[1])
            if d < best:
                best, bi = d, i
        if bi >= 0:
            used[bi] = True
            tp += 1
            errs.append(best)
    return tp, errs

# ==================== 画图 ====================
def draw_bev_boxes(ax, boxes, color, labels=None, names=None, lw=1.5):
    for i, b in enumerate(boxes):
        c = box_corners_bev(b)
        ax.add_patch(Polygon(c[:, ::-1], closed=True, fill=False,
                             edgecolor=color, linewidth=lw))   # 画图坐标 = (y, x)
        front = (c[0] + c[1]) / 2                               # 车头中点
        ax.plot([b[1], front[1]], [b[0], front[0]], color=color, lw=lw)
        if labels is not None and names is not None:
            ax.text(b[1], b[0] + 2, names[int(labels[i])], color=color,
                    fontsize=6, ha='center', va='bottom')

def setup_bev_ax(ax, pc, title):
    ax.set_xlim(-pc, pc)
    ax.set_ylim(-pc, pc)
    ax.set_aspect('equal')
    ax.set_title(title, fontsize=10)
    ax.set_xlabel('y (m)  →右', fontsize=8)
    ax.set_ylabel('x (m)  ↑前', fontsize=8)
    ax.tick_params(labelsize=7)
    # 自车
    ax.add_patch(Polygon([[-0.9, 2.3], [0.9, 2.3], [0.9, -2.3], [-0.9, -2.3]],
                         closed=True, color='white', ec='black', lw=1, zorder=5))
    ax.annotate('', xy=(0, 6), xytext=(0, 0),
                arrowprops=dict(arrowstyle='->', color='black'), zorder=6)

def render_frame(save_path, imgs, l2i, gt_boxes, gt_labels,
                 pr_boxes, pr_scores, pr_labels,
                 gt_hm, pred_hm, bev_feat, coverage,
                 pc, cam_names, cls_names, args, title):
    N = imgs.shape[0]
    img_h, img_w = imgs.shape[-2:]
    ext = [-pc, pc, -pc, pc]   # imshow: 行0=x最大(上), 列0=y最小(左) —— 与 _make_coords 一致

    fig = plt.figure(figsize=(22, 14))
    gs = GridSpec(3, 12, figure=fig, height_ratios=[1, 1, 1.45],
                  hspace=0.25, wspace=0.5)

    # ---- 相机图 ----
    for n in range(N):
        ax = fig.add_subplot(gs[n // 3, (n % 3) * 4:(n % 3) * 4 + 4])
        ax.imshow(to_rgb(imgs[n], args.bgr))
        # 相机图上只画高分预测,否则低阈值时 100 个框会糊满整张图
        cam_pr = pr_boxes[pr_scores >= args.cam_score_thr] if len(pr_boxes) else pr_boxes
        for boxes, color in ((gt_boxes, GT_COLOR), (cam_pr, PRED_COLOR)):
            for b in boxes:
                uv, d = project(box_corners_3d(b, args.z_bottom), l2i[n])
                # 角点离相机 <1m 时透视会把线拉到图外很远(贴脸的车会出现长斜线),直接跳过
                inside = ((uv[:, 0] > 0) & (uv[:, 0] < img_w) &
                          (uv[:, 1] > 0) & (uv[:, 1] < img_h) & (d > 1.0))
                if not inside.any():
                    continue
                for i, j in EDGES:
                    if d[i] > 1.0 and d[j] > 1.0:
                        ax.plot(uv[[i, j], 0], uv[[i, j], 1], color=color, lw=1)
        ax.set_xlim(0, img_w)
        ax.set_ylim(img_h, 0)
        ax.set_title(cam_names[n] if n < len(cam_names) else f'CAM {n}', fontsize=9)
        ax.axis('off')

    # ---- ① 相机覆盖 + GT ----
    ax = fig.add_subplot(gs[2, 0:3])
    H, W = gt_hm.shape[-2:]
    cmap = plt.get_cmap('tab10')
    rgb = np.ones((coverage.shape[1], 3))
    for n in range(N):
        rgb[coverage[n]] = np.array(cmap(n)[:3]) * 0.45 + 0.55
    overlap = coverage.sum(0) >= 2
    rgb[overlap] *= 0.75
    ax.imshow(rgb.reshape(H, W, 3), extent=ext)
    no_cov = 100 * (coverage.sum(0) == 0).mean()
    setup_bev_ax(ax, pc, f'① 相机覆盖 + GT 框 ({len(gt_boxes)} 个)\n'
                 f'深色=多相机重叠  白色=无覆盖 {no_cov:.1f}%')
    draw_bev_boxes(ax, gt_boxes, '#15803d', gt_labels, cls_names)
    ax.legend(handles=[Patch(color=cmap(n),
                             label=cam_names[n] if n < len(cam_names) else f'CAM {n}')
                       for n in range(N)], fontsize=6, loc='lower left', framealpha=0.8)

    # ---- ② GT 热力图 ----
    ax = fig.add_subplot(gs[2, 3:6])
    ax.imshow(gt_hm.max(0), extent=ext, cmap='magma', vmin=0, vmax=1)
    setup_bev_ax(ax, pc, '② GT 热力图(训练目标)')

    # ---- ③ 预测热力图 ----
    ax = fig.add_subplot(gs[2, 6:9])
    im = ax.imshow(pred_hm.max(0), extent=ext, cmap='magma', vmin=0, vmax=1)
    setup_bev_ax(ax, pc, f'③ 预测热力图  峰值={pred_hm.max():.2f}')
    fig.colorbar(im, ax=ax, fraction=0.046, pad=0.02)

    # ---- ④ BEV 特征 PCA + 框 ----
    ax = fig.add_subplot(gs[2, 9:12])
    ax.imshow(pca_rgb(bev_feat), extent=ext)
    setup_bev_ax(ax, pc, f'④ BEV 特征(PCA)  绿=GT  红=预测({len(pr_boxes)})')
    draw_bev_boxes(ax, gt_boxes, GT_COLOR, lw=1.8)
    draw_bev_boxes(ax, pr_boxes, PRED_COLOR, lw=1.2)
    for b, s in zip(pr_boxes, pr_scores):
        ax.text(b[1], b[0] - 3.5, f'{s:.2f}', color=PRED_COLOR, fontsize=6, ha='center')

    fig.suptitle(title, fontsize=13)
    fig.savefig(save_path, dpi=args.dpi, bbox_inches='tight')
    plt.close(fig)

def setup_cjk_font(path=None):
    """找一个能显示中文的字体;找不到就提示安装方法(不影响出图,只是中文成方块)"""
    from matplotlib import font_manager
    cands = [path] if path else []
    keys = ('notosanscjk', 'notoserifcjk', 'notosanssc', 'wqy', 'wenquanyi',
            'simhei', 'simsun', 'msyh', 'droidsansfallback', 'sourcehansans', 'arphic', 'uming')
    if not path:
        for f in font_manager.findSystemFonts():
            n = os.path.basename(f).lower().replace('-', '').replace('_', '')
            if any(k in n for k in keys):
                cands.append(f)
    for f in cands:
        try:
            font_manager.fontManager.addfont(f)
            name = font_manager.FontProperties(fname=f).get_name()
            plt.rcParams['font.sans-serif'] = [name, 'DejaVu Sans']
            plt.rcParams['axes.unicode_minus'] = False
            print(f'[font] 使用中文字体: {name}  ({f})')
            return
        except Exception:
            continue
    print('[font] 没找到中文字体,图里中文会显示成方块。解决方法(任选一个):\n'
          '       sudo apt install fonts-noto-cjk && rm -rf ~/.cache/matplotlib\n'
          '       或下载任意中文 .ttf/.otf 后加参数 --font /路径/字体.otf')

# ==================== 主流程 ====================
def main():
    ap = argparse.ArgumentParser()
    ap.add_argument('--ckpt', default='./work_dir/best.pth')
    ap.add_argument('--root', default=None, help='默认用 ckpt 里记录的 root')
    ap.add_argument('--split', default='val')
    ap.add_argument('--out', default='./vis')
    ap.add_argument('--num', type=int, default=20, help='可视化多少帧(-1=全部)')
    ap.add_argument('--stride', type=int, default=1, help='隔几帧取一帧')
    ap.add_argument('--score-thr', type=float, default=0.3)
    ap.add_argument('--dist-thr', type=float, default=2.0, help='匹配距离阈值(米)')
    ap.add_argument('--cam-names', default='CAM0,CAM1,CAM2,CAM3,CAM4,CAM5',
                    help='按数据集里的相机顺序填,例如 FRONT,FRONT_RIGHT,...')
    ap.add_argument('--class-names', default='cls0,cls1,cls2,cls3')
    ap.add_argument('--z-bottom', action='store_true', help='若数据集中 z 是框底面高度')
    ap.add_argument('--bgr', action='store_true', help='图像颜色发蓝时加上')
    ap.add_argument('--cam-score-thr', type=float, default=0.3,
                    help='相机图上只画分数高于此值的预测框(BEV 面板仍按 --score-thr)')
    ap.add_argument('--font', default=None, help='中文字体文件路径(.ttf/.ttc/.otf)')
    ap.add_argument('--blank-test', action='store_true',
                    help='输入图像全置 0:若仍能"命中",说明模型在背场景位置而不是在看图')
    ap.add_argument('--dpi', type=int, default=90)
    ap.add_argument('--video', action='store_true', help='把所有帧合成 mp4(失败则 gif)')
    args = ap.parse_args()

    setup_cjk_font(args.font)

    device = torch.device('cuda' if torch.cuda.is_available() else 'cpu')
    ckpt = torch.load(args.ckpt, map_location='cpu', weights_only=False)
    a = ckpt['args']
    print(f"[ckpt] epoch={ckpt['epoch']}  val_loss={ckpt['val_loss']:.4f}  "
          f"bev={a['bev_size']} layers={a['num_layers']} img={a['img_w']}x{a['img_h']}")

    model = MiniBEVFormer(bev_size=(a['bev_size'], a['bev_size']),
                          pc_range=a['pc_range'], num_layers=a['num_layers'],
                          num_classes=a['num_classes'], pretrained=False)
    model.load_state_dict(ckpt['model'])
    model.to(device).eval()

    # 用 hook 截获送进检测头之前的 BEV 特征 [B,256,H,W]
    cache = {}
    model.head.register_forward_hook(lambda m, i, o: cache.__setitem__('bev', i[0]))

    ds = BEVDataset(args.root or a['root'], args.split,
                    img_size=(a['img_w'], a['img_h']),
                    pc_range=a['pc_range'], augment=False)
    dl = DataLoader(ds, batch_size=1, shuffle=False, num_workers=0,
                    collate_fn=bev_collate_fn)
    os.makedirs(args.out, exist_ok=True)

    pc = a['pc_range']
    cam_names = args.cam_names.split(',')
    cls_names = args.class_names.split(',')
    coverage = None
    tot_gt = tot_pr = tot_tp = 0
    all_err, saved = [], []

    for fi, batch in enumerate(dl):
        if fi % args.stride:
            continue
        if 0 <= args.num <= len(saved):
            break

        imgs = batch['imgs'].to(device)
        if args.blank_test:              # 对照实验:把图像全换成 0,看模型是不是在"背位置"
            imgs = torch.zeros_like(imgs)
        l2i = batch['lidar2img'].to(device)
        with torch.no_grad():
            out = model(imgs, l2i)

        gt_boxes = batch['gt_boxes'][0].numpy().reshape(-1, 7)
        gt_labels = batch['gt_labels'][0].numpy().reshape(-1)
        gt_hm, _, _ = encode_targets(gt_boxes, gt_labels, bev_size=a['bev_size'],
                                     pc_range=pc, num_classes=a['num_classes'])
        # 只评估 BEV 范围内的 GT(范围外的 encode_targets 也没画)
        inr = (np.abs(gt_boxes[:, 0]) < pc) & (np.abs(gt_boxes[:, 1]) < pc)
        gt_boxes, gt_labels = gt_boxes[inr], gt_labels[inr]
        # 自检:GT 里是否混入了自车(中心落在原点附近 = 采集脚本没把 ego 排除)
        ego = (np.abs(gt_boxes[:, 0]) < 1.5) & (np.abs(gt_boxes[:, 1]) < 1.0)
        if ego.any():
            print(f'  ⚠ frame {fi}: 有 {ego.sum()} 个 GT 框中心在自车位置,'
                  f'可能把自车也标成了目标 → {gt_boxes[ego][:, :3].round(2).tolist()}')

        pr_boxes, pr_scores, pr_labels = decode(out, pc, args.score_thr)
        pred_hm = torch.sigmoid(out['heatmap'][0].float()).cpu().numpy()

        l2i_np = l2i[0].cpu().numpy()
        if coverage is None:          # 相机外参不变,只算一次
            coverage = camera_coverage(l2i_np, model.bev_coords.cpu().numpy(),
                                       a['img_w'], a['img_h'])

        tp, errs = match(gt_boxes, gt_labels, pr_boxes, pr_labels, args.dist_thr)
        tot_gt += len(gt_boxes); tot_pr += len(pr_boxes); tot_tp += tp
        all_err += errs
        print(f"frame {fi:4d} | GT {len(gt_boxes):3d} | pred {len(pr_boxes):3d} | "
              f"命中 {tp:3d} | 热力图峰值 {pred_hm.max():.3f}")

        path = os.path.join(args.out, f'frame_{fi:05d}.png')
        title = (f'frame {fi}   GT {len(gt_boxes)}  pred {len(pr_boxes)}  '
                 f'命中 {tp} (同类 & 中心距 < {args.dist_thr}m)   阈值 {args.score_thr}')
        render_frame(path, batch['imgs'][0], l2i_np, gt_boxes, gt_labels,
                     pr_boxes, pr_scores, pr_labels, gt_hm.numpy(), pred_hm,
                     cache['bev'][0], coverage, pc, cam_names, cls_names, args, title)
        saved.append(path)

    # ---- 汇总 ----
    P = tot_tp / max(tot_pr, 1)
    R = tot_tp / max(tot_gt, 1)
    print('\n==== 汇总 ====')
    print(f'帧数 {len(saved)} | GT {tot_gt} | 预测 {tot_pr} | 命中 {tot_tp}')
    print(f'Precision {P:.3f} | Recall {R:.3f} | '
          f'命中框平均中心误差 {np.mean(all_err) if all_err else float("nan"):.2f} m')
    print(f'图片保存在 {os.path.abspath(args.out)}')

    if args.video and saved:
        try:
            import imageio.v2 as imageio
            frames = [imageio.imread(p)[..., :3] for p in saved]
            h = min(f.shape[0] for f in frames) // 2 * 2
            w = min(f.shape[1] for f in frames) // 2 * 2
            frames = [f[:h, :w] for f in frames]
            try:
                imageio.mimsave(os.path.join(args.out, 'bev.mp4'), frames, fps=5)
                print('视频: bev.mp4')
            except Exception:
                imageio.mimsave(os.path.join(args.out, 'bev.gif'), frames, duration=0.2)
                print('动图: bev.gif')
        except ImportError:
            print('没装 imageio,可用: ffmpeg -framerate 5 -pattern_type glob '
                  f"-i '{args.out}/frame_*.png' -pix_fmt yuv420p bev.mp4")

if __name__ == '__main__':
    main()
执行代码:
(ad) leoking@leoking-desktop:~/carla/work/courses/M2/2.3$ python vis_bev.py --ckpt ./work_dir/last.pth --root ../dataset_all \
    --split train --out ./vis_overfit --score-thr 0.3 \
    --cam-names FRONT,FRONT_LEFT,FRONT_RIGHT,BACK,BACK_LEFT,BACK_RIGHT
[font] 使用中文字体: Noto Serif CJK JP  (/usr/share/fonts/opentype/noto/NotoSerifCJK-Bold.ttc)
[ckpt] epoch=23  val_loss=4.4502  bev=128 layers=3 img=448x256
[train] 8 场景, 16000 帧
frame    0 | GT  16 | pred   1 | 命中   0 | 热力图峰值 0.376
frame    1 | GT  16 | pred   2 | 命中   0 | 热力图峰值 0.395
frame    2 | GT  16 | pred   1 | 命中   0 | 热力图峰值 0.415
frame    3 | GT  13 | pred   1 | 命中   0 | 热力图峰值 0.389
frame    4 | GT  14 | pred   1 | 命中   0 | 热力图峰值 0.385
frame    5 | GT  14 | pred   1 | 命中   0 | 热力图峰值 0.387
frame    6 | GT  15 | pred   1 | 命中   0 | 热力图峰值 0.376
frame    7 | GT  14 | pred   2 | 命中   0 | 热力图峰值 0.401
frame    8 | GT  16 | pred   1 | 命中   0 | 热力图峰值 0.375
frame    9 | GT  15 | pred   2 | 命中   0 | 热力图峰值 0.372
frame   10 | GT  14 | pred   1 | 命中   0 | 热力图峰值 0.379
frame   11 | GT  15 | pred   1 | 命中   0 | 热力图峰值 0.406
frame   12 | GT  16 | pred   1 | 命中   0 | 热力图峰值 0.382
frame   13 | GT  14 | pred   1 | 命中   0 | 热力图峰值 0.374
frame   14 | GT  16 | pred   1 | 命中   0 | 热力图峰值 0.377
frame   15 | GT  16 | pred   1 | 命中   0 | 热力图峰值 0.373
frame   16 | GT  15 | pred   1 | 命中   0 | 热力图峰值 0.365
frame   17 | GT  16 | pred   1 | 命中   0 | 热力图峰值 0.350
frame   18 | GT  15 | pred   2 | 命中   0 | 热力图峰值 0.347
frame   19 | GT  14 | pred   2 | 命中   0 | 热力图峰值 0.333

==== 汇总 ====
帧数 20 | GT 300 | 预测 25 | 命中 0
Precision 0.000 | Recall 0.000 | 命中框平均中心误差 nan m
图片保存在 /home/leoking/carla/work/courses/M2/2.3/vis_overfit
(ad) leoking@leoking-desktop:~/carla/work/courses/M2/2.3$ 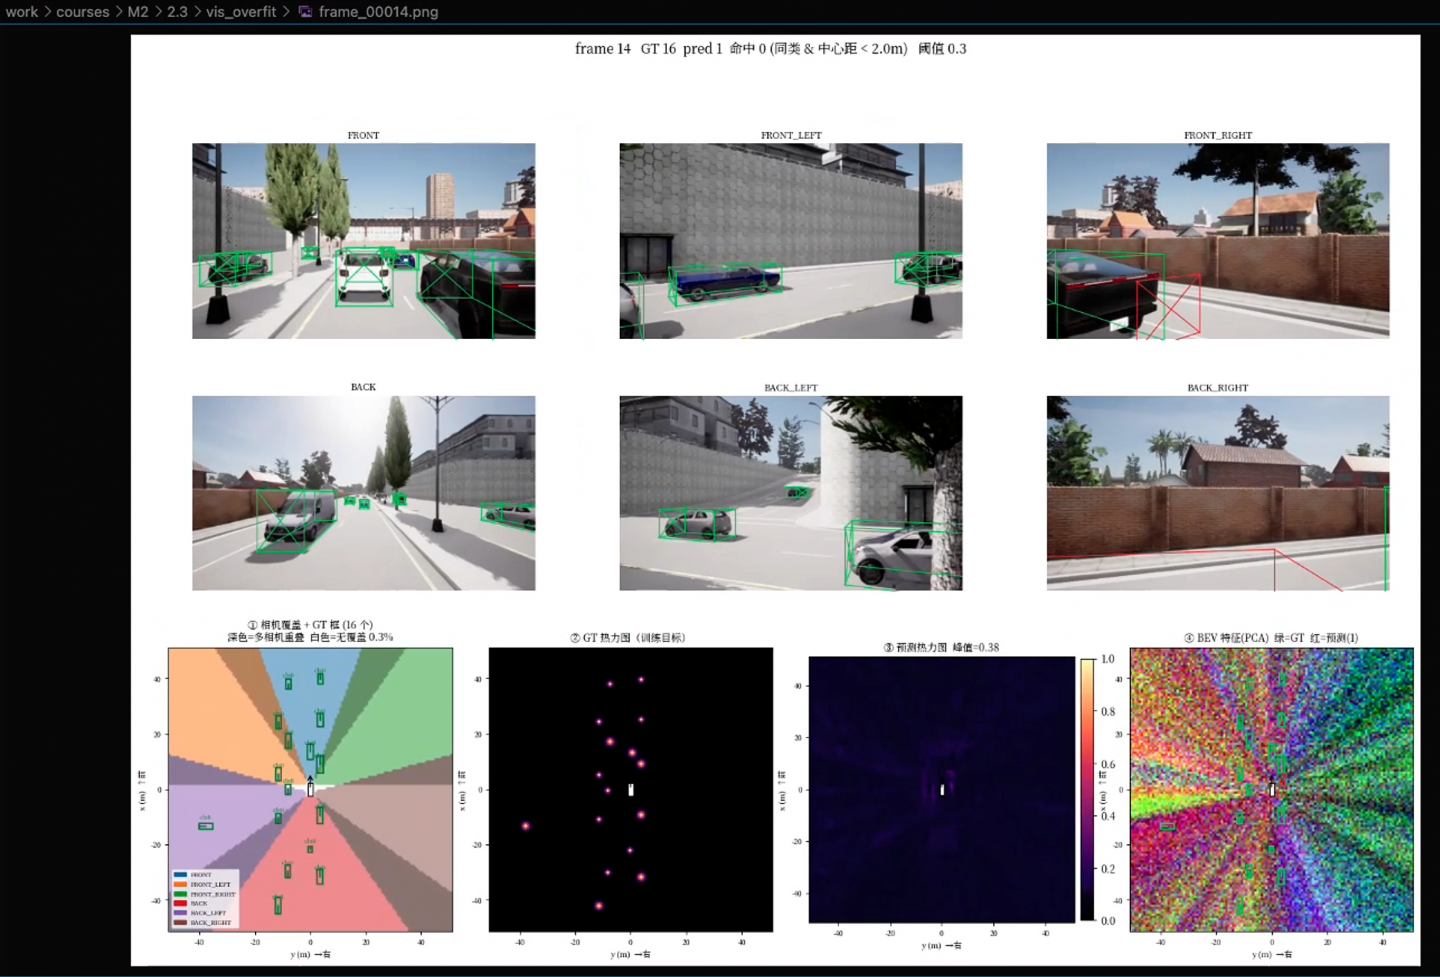
为者常成,行者常至
自由转载-非商用-非衍生-保持署名(创意共享3.0许可证)


