

自动驾驶-M2 感知与 BEV-2.3 BEVFormer 训练实战
本节做一个重要的技术决策:不用官方仓库,自己实现精简版—— 理由在下面,这不是偷懒,是在你的硬件上唯一正确的选择。学习课程 端到端自动驾驶实战 | zhijia.dev
第一步:环境准备
conda activate ad

# 只需要这些 —— 没有 mmcv、没有版本地狱
pip install torch==2.1.2 torchvision==0.16.2 \
    --index-url https://download.pytorch.org/whl/cu121
pip install tensorboard tqdm

# 验证
python -c "
import torch, torchvision
print('torch', torch.__version__)
print('cuda 可用:', torch.cuda.is_available())
print('设备:', torch.cuda.get_device_name(0))
print('算力: sm_%d%d' % torch.cuda.get_device_capability(0))
"
# 期望输出算力 sm_89,且 cuda 可用为 True

--------------------------------->
输出:
(ad) leoking@byd-desktop:~/carla/work/courses/M2/2.3$ python -c "
import torch, torchvision
print('torch', torch.__version__)
print('cuda 可用:', torch.cuda.is_available())
print('设备:', torch.cuda.get_device_name(0))
print('算力: sm_%d%d' % torch.cuda.get_device_capability(0))
"
torch 2.1.2+cu121
cuda 可用: True
设备: NVIDIA L20
算力: sm_89
第二步:理解要实现什么
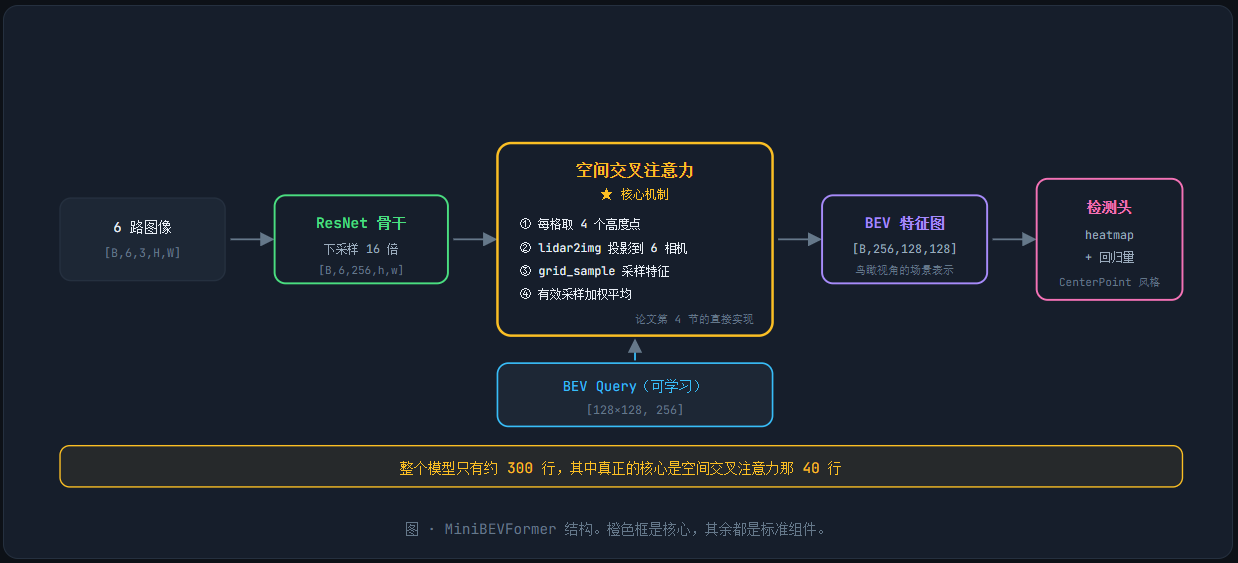
第三步:模型实现
下面是完整模型。重点看 SpatialCrossAttention 那部分—— 它是论文第 4 节的直接翻译。
mini_bevformer.py
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""
MiniBEVFormer —— 从零实现的精简版 BEVFormer

与论文版的差异(诚实说明):
    · 空间交叉注意力用「固定采样点」而非可变形偏移(机制相同)
    · 检测头用 CenterPoint 风格热力图,而非 DETR query(更易收敛)
    · 时序融合作为可选项
"""

import math

import torch
import torch.nn as nn
import torch.nn.functional as F
import torchvision

# ==================== 图像骨干 ====================

# ==================== 图像骨干 ====================
class ImageBackbone(nn.Module):
    """
    ResNet 提取多相机图像特征

    BEVFormer 链路:多相机原图 → ImageBackbone(当前这个类)得到每个相机的2D图像特征图 → 空间交叉注意力SCA:把各个相机2D特征,根据相机内外参投影到BEV鸟瞰网格上 → BEV时序融合 + Transformer → 检测头输出目标框
    这个类只负责图像端的 2D 特征提取,还没有做 BEV 投影。
    """

    def __init__(self, out_channels=256, pretrained=True):
        """
        pretrained: 控制是否加载预训练权重
        """
        # 调用父类(`nn.Module`)的构造,PyTorch 网络类必须写
        super().__init__()
        net = torchvision.models.resnet50(
            # 加载官方默认预训练权重(ImageNet 预训练)
            weights=torchvision.models.ResNet50_Weights.DEFAULT
            if pretrained else None
        )

        # 取到 layer3, 输出 stride=16, 通道 1024
        # 不是把整个 ResNet50 拿来用**,只截取前面一部分
        # ResNet50 顺序:conv1 → bn1 → relu → maxpool → layer1 → layer2 → layer3 → layer4 → fc
        # 这里**截断在 layer3,丢掉 layer4 和最后的分类头**
        # layer3 输出:下采样倍数 stride=16,通道数 = 1024, layer4 输出是 2048 通道,stride=32,这里作者不用它(为了保留更高分辨率特征,适合 BEV 感知)
        # 优点:分辨率更大,小目标特征保留更好;缺点:计算量更大
        self.stem = nn.Sequential(
            net.conv1, net.bn1, net.relu, net.maxpool,
            net.layer1, net.layer2, net.layer3
        )

        # 1×1 卷积,通道投影层, 把 1024 通道 → 256 通道(out_channels,和后面 BEV Transformer 的特征维度对齐)
        # 1×1 卷积不改变特征图高宽,只改通道,是 BEV 类模型标准操作
        self.proj = nn.Conv2d(1024, out_channels, 1)

    def forward(self, imgs):
        """
        forward 前向传播
        imgs [B,N,3,H,W] → [B,N,C,H/16,W/16]

        [B, N, 3, H, W],B = 批次,N = 相机数量;输出:[B, N, C, h, w]
        B:batch size 一批多少帧
        N:每帧有多少个相机(比如 6 个相机)
        `flatten(0,1)`:把批次维和相机维合并,变成 `B*N, 3, H, W`

        原因:CNN 原生只支持 `[N,C,H,W]` 4 维输入,不能直接处理 5 维 `[B,N,3,H,W]`,所以先压扁,所有相机图片一起过 CNN,批量并行计算,效率高。
        """

        # 取前两个维度
        B, N = imgs.shape[:2]

        # `flatten(dim_start, dim_end)`:**把从 dim_start 到 dim_end 这连续几个维度合并成一个维度**

        # 这里 flatten(0,1):合并第 0 维(B)和第 1 维(N), 如 合并前:[2, 6, 3, 512, 768], 合并后:[12, 3, 512, 768]
        # 原来:[B, N, 3, H, W], 合并后:`[B × N, 3, H, W]`

        # 为什么一定要这么做?PyTorch 的 CNN(Conv2d)**只接受 4 维输入 `[batch, C, H, W]`**,不支持 5 维 `[B,N,3,H,W]`。
        # 把 B 和 N 压在一起,所有相机图片打包成一整批,一起送入 ResNet,并行计算,代码简单、速度快。
        # 后面算完特征,再用 view(B, N, C, h, w) 还原回 5 维,区分开「哪一帧、哪个相机」,给 BEV 交叉注意力用。
        x = imgs.flatten(0, 1)              # [B*N,3,H,W]

        # `self.stem` 是前面定义的 `nn.Sequential`:conv1, bn1, relu, maxpool, layer1, layer2, layer3
        # 这一串就是 ResNet50 的前半部分,不包含 layer4 和最后的分类
        # 下采样倍率:stride=16, 输出形状:[B*N, 1024, H//16, W//16], 含义:得到每一张相机图的 1024 维特征图
        # `stem` 提取 stride16、1024 维特征
        x = self.stem(x)

        # proj 映射到 256 通道
        # self.proj = nn.Conv2d(1024, out_channels, 1),这里 out_channels=256, 1×1 卷积,不会改变特征图高宽,只做通道变换
        # 形状变成:[B*N, 256, H//16, W//16], 作用:把 ResNet 输出的 1024 通道,统一映射到 256 维;
        # 后面 BEV Transformer 注意力计算固定用 256 维特征,维度对齐,这是 BEV 模型标准做法。
        x = self.proj(x)
        _, C, h, w = x.shape
        # view(B, N, C, h, w):把压扁的维度还原回来,恢复成【批次,相机数,通道,特征高,特征宽】
        return x.view(B, N, C, h, w)

# ==================== 空间交叉注意力(核心)====================
class SpatialCrossAttention(nn.Module):
    """
    BEV 格子 → 多相机图像 的特征采样

    这是 BEVFormer 论文第 4 节的核心机制:
      1. 每个 BEV 格子对应一根「柱子」,在柱子上取 Z 个高度点
      2. 把这些 3D 点用 lidar2img 投影到 6 路相机
      3. 在投影落点处采样图像特征
      4. 对所有有效采样求平均,得到该格子的特征
    """

    def __init__(self, embed_dims=256, num_heights=4,
                 z_range=(-2.0, 4.0)):
        super().__init__()
        self.embed_dims = embed_dims
        self.num_heights = num_heights
        self.z_range = z_range
        self.output_proj = nn.Linear(embed_dims, embed_dims)

    def forward(self, bev_query, img_feats, lidar2img, bev_coords):
        """
        bev_query  : [B, X*Y, C]
        img_feats  : [B, N, C, h, w]
        lidar2img  : [B, N, 4, 4]
        bev_coords : [X*Y, 2]   每格的 (x,y) 自车系坐标
        """
        B, N, C, h, w = img_feats.shape
        num_query = bev_coords.shape[0]
        Z = self.num_heights
        device = bev_query.device

        # ---- 1) 构造 3D 参考点(柱子上的 Z 个高度)----
        zs = torch.linspace(self.z_range[0], self.z_range[1], Z,
                            device=device)
        ref = torch.zeros(num_query, Z, 3, device=device)
        ref[:, :, 0] = bev_coords[:, 0:1]
        ref[:, :, 1] = bev_coords[:, 1:2]
        ref[:, :, 2] = zs.unsqueeze(0)

        ref_h = torch.cat(
            [ref.reshape(-1, 3),
             torch.ones(num_query * Z, 1, device=device)], dim=1)

        # ---- 2) 投影到各相机(一次 einsum 搞定 6 相机 × 所有点)----
        pts = torch.einsum('bnij,pj->bnpi', lidar2img, ref_h)

        depth = pts[..., 2]                          # [B,N,P]
        eps = 1e-5
        uv = pts[..., :2] / torch.clamp(depth.unsqueeze(-1), min=eps)

        # ---- 3) 有效性掩码:深度为正 且 落在图像内 ----
        img_w, img_h = w * 16, h * 16          # 骨干下采样 16 倍
        u_norm = uv[..., 0] / img_w * 2 - 1
        v_norm = uv[..., 1] / img_h * 2 - 1
        valid = ((depth > eps) &
                 (u_norm > -1) & (u_norm < 1) &
                 (v_norm > -1) & (v_norm < 1))

        grid = torch.stack([u_norm, v_norm], dim=-1)   # [B,N,P,2]

        # ---- 4) 采样图像特征 ----
        feats = img_feats.flatten(0, 1)               # [B*N,C,h,w]
        g = grid.flatten(0, 1).unsqueeze(2)           # [B*N,P,1,2]
        sampled = F.grid_sample(feats, g, mode='bilinear',
                                padding_mode='zeros',
                                align_corners=False)      # [B*N,C,P,1]
        sampled = sampled.squeeze(-1).permute(0, 2, 1)
        sampled = sampled.view(B, N, num_query, Z, C)

        # ---- 5) 按有效性加权平均 ----
        m = valid.view(B, N, num_query, Z, 1).float()
        summed = (sampled * m).sum(dim=(1, 3))          # [B,P,C]
        count = m.sum(dim=(1, 3)).clamp(min=1.0)
        out = summed / count

        # 残差连接(Transformer 标配,见论文①第 7 节)
        return self.output_proj(out) + bev_query

# ==================== BEV 编码器 ====================
class BEVEncoder(nn.Module):
    def __init__(self, embed_dims=256, num_layers=3, num_heights=4):
        super().__init__()
        self.layers = nn.ModuleList()
        for _ in range(num_layers):
            self.layers.append(nn.ModuleDict({
                'sca': SpatialCrossAttention(embed_dims, num_heights),
                'norm1': nn.LayerNorm(embed_dims),
                'ffn': nn.Sequential(
                    nn.Linear(embed_dims, embed_dims * 2),
                    nn.ReLU(inplace=True),
                    nn.Linear(embed_dims * 2, embed_dims)),
                'norm2': nn.LayerNorm(embed_dims),
            }))

    def forward(self, bev_query, img_feats, lidar2img, bev_coords):
        x = bev_query
        for layer in self.layers:
            x = layer['norm1'](
                layer['sca'](x, img_feats, lidar2img, bev_coords))
            x = layer['norm2'](x + layer['ffn'](x))
        return x

# ==================== 检测头 ====================
class CenterHead(nn.Module):
    """
    热力图检测头 —— 比 DETR 风格的 query 头更容易训练收敛

    输出:
        heatmap : [B, num_cls, Y, X]  每类的中心点热力图
        reg     : [B, 8, Y, X]  offset(2)+z(1)+logsize(3)+sincos(2)
    """

    def __init__(self, in_channels=256, num_classes=4):
        super().__init__()
        self.shared = nn.Sequential(
            nn.Conv2d(in_channels, 128, 3, padding=1),
            nn.BatchNorm2d(128), nn.ReLU(inplace=True),
            nn.Conv2d(128, 128, 3, padding=1),
            nn.BatchNorm2d(128), nn.ReLU(inplace=True),
        )
        self.hm_head = nn.Conv2d(128, num_classes, 1)
        self.reg_head = nn.Conv2d(128, 8, 1)
        # 热力图偏置初始化为负,避免训练初期大量假正例(CenterNet 惯例)
        self.hm_head.bias.data.fill_(-2.19)

    def forward(self, bev_feat):
        x = self.shared(bev_feat)
        return {'heatmap': self.hm_head(x), 'reg': self.reg_head(x)}

# ==================== 完整模型 ====================
class MiniBEVFormer(nn.Module):

    def __init__(self, bev_size=(128, 128), pc_range=51.2,
                 embed_dims=256, num_layers=3,
                 num_classes=4, pretrained=True):
        super().__init__()
        self.bev_h, self.bev_w = bev_size
        self.pc_range = pc_range
        self.embed_dims = embed_dims

        self.backbone = ImageBackbone(embed_dims, pretrained)
        # BEV query:可学习参数,这是 BEVFormer 的精髓(论文第 3 节)
        self.bev_embedding = nn.Embedding(
            self.bev_h * self.bev_w, embed_dims)
        self.encoder = BEVEncoder(embed_dims, num_layers)
        self.head = CenterHead(embed_dims, num_classes)

        # 预计算每格的自车系坐标(不参与训练)
        self.register_buffer('bev_coords', self._make_coords())

    def _make_coords(self):
        """生成 BEV 网格中心点的自车系坐标 [X*Y, 2]"""
        # x 向前(图像上方),y 向右
        xs = torch.linspace(self.pc_range, -self.pc_range, self.bev_h)
        ys = torch.linspace(-self.pc_range, self.pc_range, self.bev_w)
        gx, gy = torch.meshgrid(xs, ys, indexing='ij')
        return torch.stack([gx.flatten(), gy.flatten()], dim=1)

    def forward(self, imgs, lidar2img):
        B = imgs.shape[0]
        img_feats = self.backbone(imgs)

        bev_q = self.bev_embedding.weight.unsqueeze(0).repeat(B, 1, 1)
        bev = self.encoder(bev_q, img_feats, lidar2img, self.bev_coords)

        # [B, X*Y, C] → [B, C, Y, X]
        bev = bev.permute(0, 2, 1).reshape(
            B, self.embed_dims, self.bev_h, self.bev_w)
        return self.head(bev)

# ==================== 损失函数 ====================
def focal_loss(pred, target, alpha=2.0, beta=4.0):
    """CenterNet 风格的 focal loss(处理正负样本极度不平衡)"""
    pred = torch.clamp(torch.sigmoid(pred), 1e-4, 1 - 1e-4)
    pos_mask = target.eq(1).float()
    neg_mask = 1 - pos_mask

    pos_loss = -torch.log(pred) * torch.pow(1 - pred, alpha) * pos_mask
    neg_loss = (-torch.log(1 - pred) * torch.pow(pred, alpha)
                * torch.pow(1 - target, beta) * neg_mask)

    n_pos = pos_mask.sum()
    if n_pos == 0:
        return neg_loss.sum()
    return (pos_loss.sum() + neg_loss.sum()) / n_pos

# ==================== 自测 ====================
if __name__ == '__main__':
    print("=== MiniBEVFormer 形状与前向测试 ===")
    model = MiniBEVFormer(bev_size=(64, 64), num_layers=2,
                          pretrained=False)
    n = sum(p.numel() for p in model.parameters())
    print(f"参数量: {n/1e6:.1f} M")

    B, N, H, W = 2, 6, 256, 448
    imgs = torch.randn(B, N, 3, H, W)
    l2i = torch.eye(4).repeat(B, N, 1, 1)
    f = W / (2 * math.tan(math.radians(70) / 2))
    K = torch.tensor([[f, 0, W/2], [0, f, H/2], [0, 0, 1]])
    R = torch.tensor([[0., 1., 0.], [0., 0., -1.], [1., 0., 0.]])
    l2i[:, :, :3, :3] = K @ R

    model.eval()
    with torch.no_grad():
        out = model(imgs, l2i)
    print(f"heatmap: {tuple(out['heatmap'].shape)}")
    print(f"reg    : {tuple(out['reg'].shape)}")

    model.train()
    out = model(imgs, l2i)
    tgt = torch.zeros_like(out['heatmap']); tgt[0, 0, 30, 30] = 1.0
    loss = focal_loss(out['heatmap'], tgt)
    loss.backward()
    g = sum(p.grad.abs().sum().item() for p in model.parameters()
            if p.grad is not None)
    print(f"loss: {loss.item():.4f} | 梯度总量: {g:.1f} "
          f"{'✓' if g > 0 else '✗'}")
代码解析:
总体介绍
MiniBEVFormer 是一个精简版的 BEVFormer,用于多相机(通常 6 路)图像到鸟瞰图(Bird’s-Eye-View, BEV)特征的转换,并做 3D 目标检测。
核心思想(与原论文一致):
- 在自车坐标系下预先定义一个规则的 BEV 网格(例如 128×128)。
- 每个格子拥有一个可学习的 Query 向量。
- 通过空间交叉注意力(Spatial Cross Attention),把每个 BEV 格子对应的“柱子”上的多个高度点投影到各相机图像上,采样图像特征,再聚合回该格子。
- 多层 Encoder 迭代 refine BEV 特征后,用 CenterPoint 风格的热力图头做检测。
与原版 BEVFormer 的主要简化(代码注释已说明):
- 采样点是固定高度,而非可变形偏移(机制相同,实现更简单)。
- 检测头用热力图而非 DETR 式 Query。
- 时序融合可选(本代码未实现)。
整体数据流非常清晰:
多相机图像 [B,N,3,H,W]
        ↓ ImageBackbone (ResNet50, stride=16)
图像特征 [B,N,C,h,w]
        ↓
可学习 BEV Query [B, X*Y, C]  +  预计算坐标 bev_coords [X*Y, 2]
        ↓ BEVEncoder(多层 SpatialCrossAttention + FFN)
BEV 特征 [B, X*Y, C] → reshape 为 [B, C, Y, X]
        ↓ CenterHead
heatmap [B, num_cls, Y, X]  +  reg [B, 8, Y, X]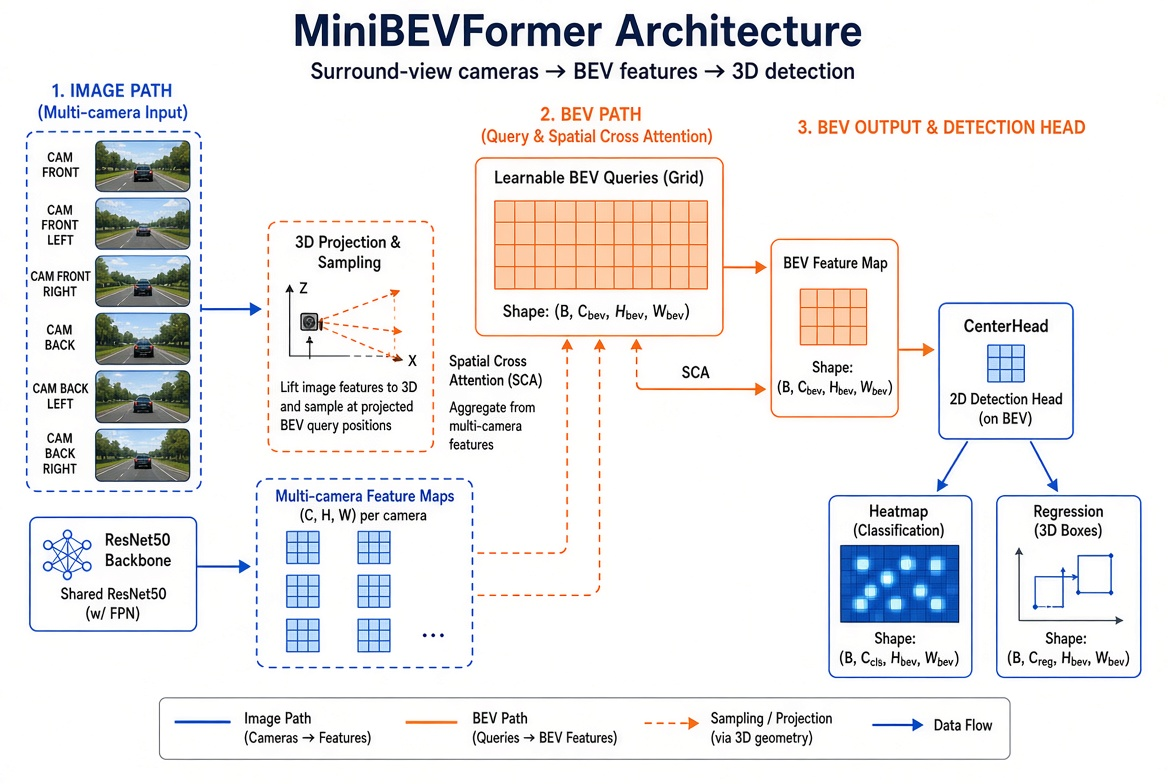
1. 图像骨干 ImageBackbone
使用预训练 ResNet50,只取到 layer3(输出 stride=16,通道 1024),再 1×1 卷积降到 embed_dims(默认 256)。
维度变化(假设输入图像 H=256, W=448):
- 输入:
[B, N, 3, H, W](N=6 路相机) - flatten 后:
[B*N, 3, H, W] - stem 后:
[B*N, 1024, H/16, W/16] - proj 后:
[B*N, C, h, w](h=H/16, w=W/16) - 最终 reshape:
[B, N, C, h, w]
这一步只是提取多尺度图像特征,后续所有几何投影都基于这些特征图。
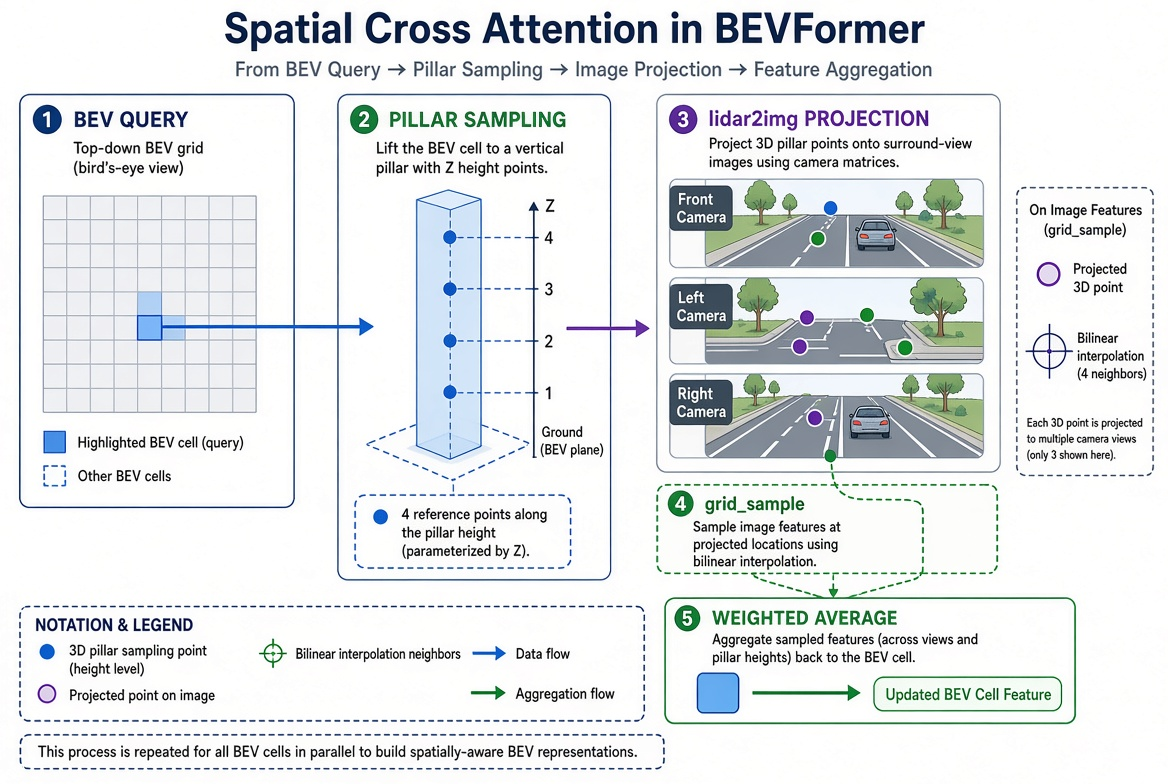
2. 空间交叉注意力 SpatialCrossAttention(核心)
这是整个模型最关键的部分,对应 BEVFormer 论文第 4 节。
流程详解:
-
构造 3D 参考点(柱子)
- 每个 BEV 格子有一个 (x, y) 坐标(自车系,来自
bev_coords)。 - 在该 (x, y) 上沿 Z 轴均匀取
num_heights(默认 4)个高度点,范围z_range=(-2, 4)。 - 得到参考点
ref:[num_query, Z, 3],再齐次化为[num_query*Z, 4]。
- 每个 BEV 格子有一个 (x, y) 坐标(自车系,来自
-
一次性投影到所有相机
lidar2img:[B, N, 4, 4](外参 + 内参矩阵)。- 用
einsum把所有点投影到 N 个相机:pts = [B, N, P, 4](P = num_query*Z)。 - 计算深度
depth = pts[..., 2],归一化得到像素坐标uv。
-
有效性掩码
- 深度 > 0 且投影落在图像范围内(归一化到 [-1,1] 后判断)。
- 得到
valid:[B, N, P]。
-
特征采样
- 用
F.grid_sample在图像特征上双线性插值采样。 - 采样结果 reshape 为
[B, N, num_query, Z, C]。
- 用
-
加权平均聚合
- 只对有效采样点做平均,得到每个 BEV 格子的特征
[B, num_query, C]。 - 最后做线性投影 + 残差连接(加回原始
bev_query)。
- 只对有效采样点做平均,得到每个 BEV 格子的特征
维度关键变化总结:
| 步骤 | 张量形状 | 说明 |
|---|---|---|
| bev_coords | [X*Y, 2] |
预计算的网格中心 |
| ref_h | [X*Y*Z, 4] |
齐次 3D 点 |
| pts | [B, N, X*Y*Z, 4] |
投影后 |
| grid | [B, N, X*Y*Z, 2] |
归一化采样坐标 |
| sampled | [B, N, X*Y, Z, C] |
采样特征 |
| out | [B, X*Y, C] |
聚合后 + 残差 |
这个模块实现了“BEV 格子主动去图像里找特征”的机制,是 BEVFormer 能从多相机直接得到统一 BEV 表示的关键。
3. BEV 编码器 BEVEncoder
标准的 Transformer Encoder 风格堆叠:
- 每层:
LayerNorm → SpatialCrossAttention → LayerNorm → FFN(残差) - 默认 3 层。
- 输入输出都是
[B, X*Y, C]。
多层迭代可以让 BEV Query 逐渐 refine,更好地融合不同高度和不同相机的信息。
4. 检测头 CenterHead
CenterPoint 风格:
- 共享卷积把通道从 256 降到 128。
- 两个 1×1 头:
heatmap:[B, num_classes, Y, X](中心点热力图)reg:[B, 8, Y, X](offset(2) + z(1) + log(size)(3) + sin/cos(rot)(2))
- 热力图 bias 初始化为 -2.19,减少训练初期假正例(CenterNet 惯例)。
5. 完整模型 MiniBEVFormer
bev_embedding:可学习参数[X*Y, C],这是 BEVFormer 的精髓(每个格子一个 Query)。_make_coords:生成自车系网格坐标(x 向前,y 向右,范围 ±pc_range)。- forward 中把序列特征 reshape 成 2D 特征图后送入检测头。
6. 损失函数 focal_loss
标准 CenterNet 风格 Focal Loss,专门处理正负样本极度不平衡。正样本只有中心点为 1,其余为高斯软标签或 0。
自测部分
代码末尾的 __main__ 做了形状测试和简单反向传播检查,验证模型能正常跑通并产生梯度。
总结与建议
这个实现非常适合学习和二次开发:
- 空间交叉注意力逻辑完整、维度清晰。
- 可直接替换成可变形注意力(Deformable Attention)进一步接近原版。
- 检测头可换成 DETR 风格或增加时序融合模块。
如果你需要我把某个模块改成可变形版本、加上时序、或者画出更详细的某一部分(例如投影几何细节),直接告诉我即可。
为者常成,行者常至
自由转载-非商用-非衍生-保持署名(创意共享3.0许可证)


