

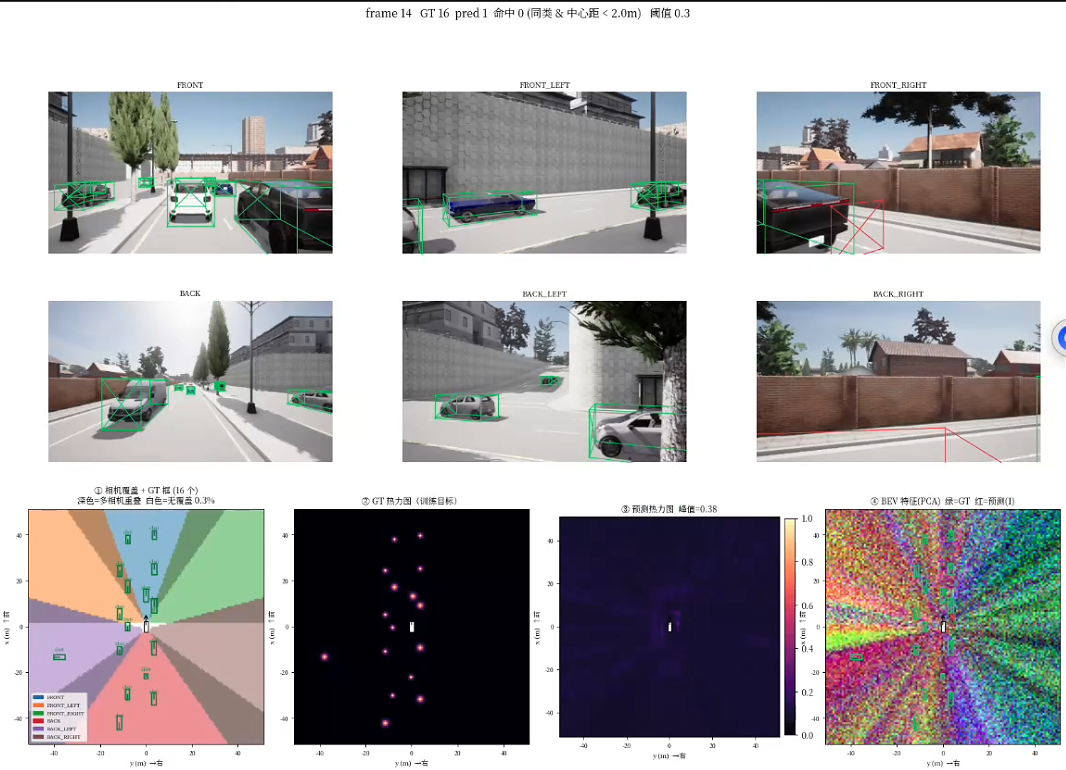
自动驾驶-M2 感知与 BEV-2.3.4.1 BEVFormer 训练实战代码-相机覆盖 +GT 框 (执行结果展示)
本节做一个重要的技术决策:不用官方仓库,自己实现精简版—— 理由在下面,这不是偷懒,是在你的硬件上唯一正确的选择。学习课程 端到端自动驾驶实战 | zhijia.dev
learn_projection.py 源码:
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""
learn_projection.py —— 一步一步拆解「相机覆盖图」和「3D 框投影」

  ① 合成模式(不需要数据集,笔记本上也能跑):
        python learn_projection.py
  ② 真实数据(放在 2.3 目录下运行,用你自己的 bev_dataset.py):
        python learn_projection.py --root ../dataset_v4 --split val --frame 8
  ③ 每一步停下来看变量(pdb 断点):
        python learn_projection.py --pause
        停下后常用命令:  p 变量名 / pp 变量名 / p 变量.shape / n 下一行 / c 继续 / q 退出

  输出: ./learn_out/step1_*.png ... step9_*.png
  代码里写着【断点 N】的地方,就是建议在 VS Code 里打断点的行。

  全流程:
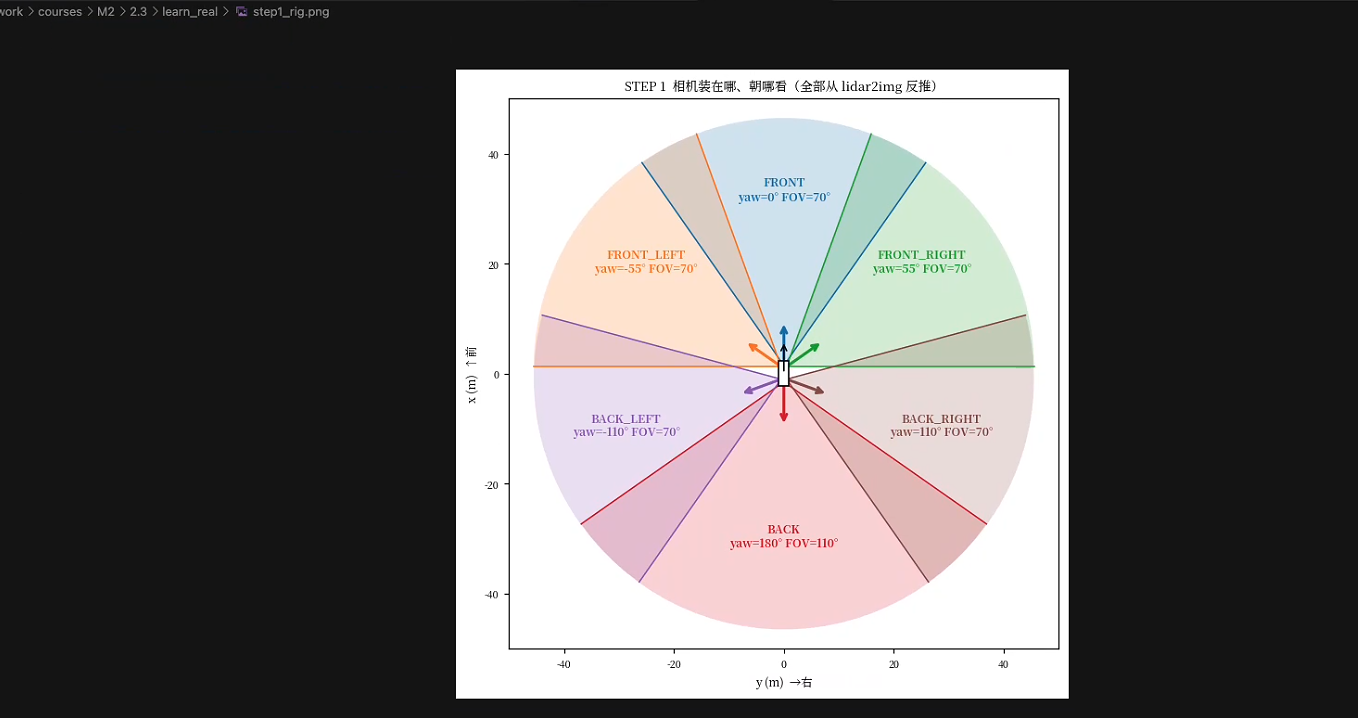
    STEP 1  读懂 lidar2img:从 4×4 矩阵反推出每个相机装在哪、朝哪看
    STEP 2  BEV 网格:每个格子中心的 (x, y) 坐标
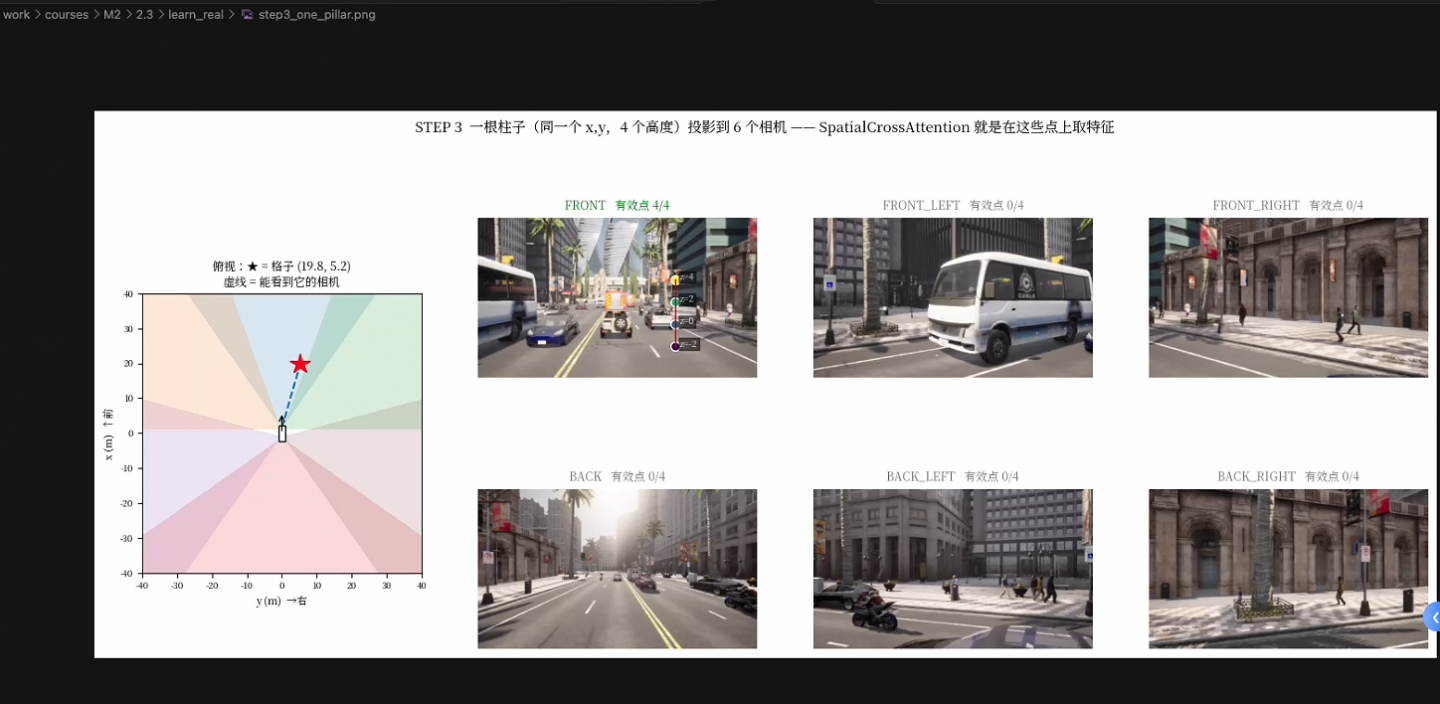
    STEP 3  追踪一根柱子:1 个格子 × 4 个高度 → 投影到 6 个相机
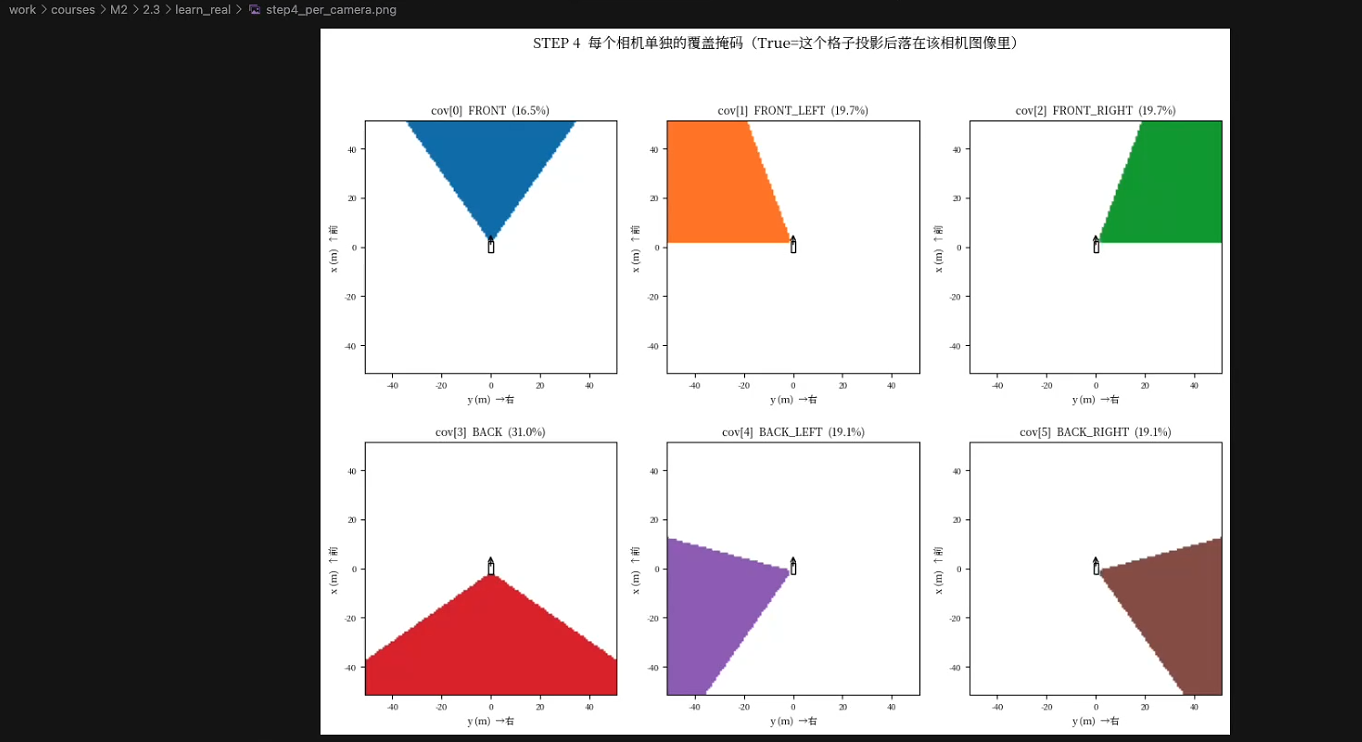
    STEP 4  全网格覆盖:16384 个格子 × 4 高度 × 6 相机 一次算完 → cov[6, 16384]
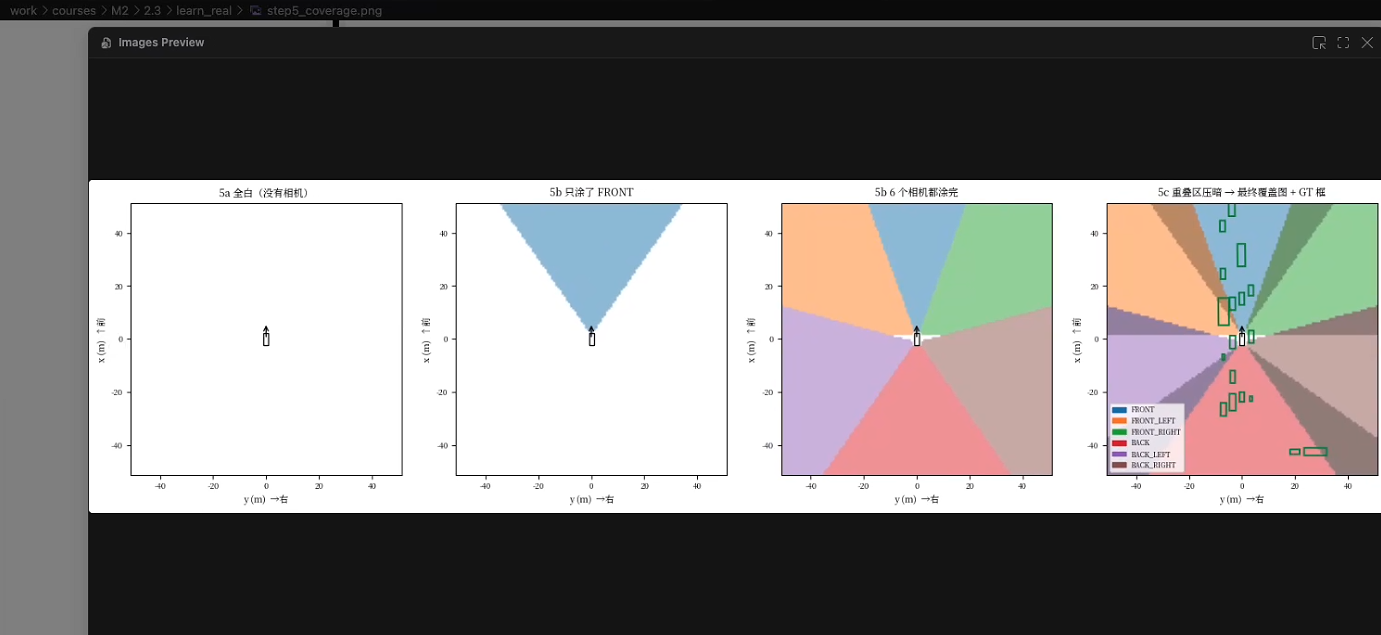
    STEP 5  上色:cov → RGB 覆盖图(就是 vis 里的面板 ①)
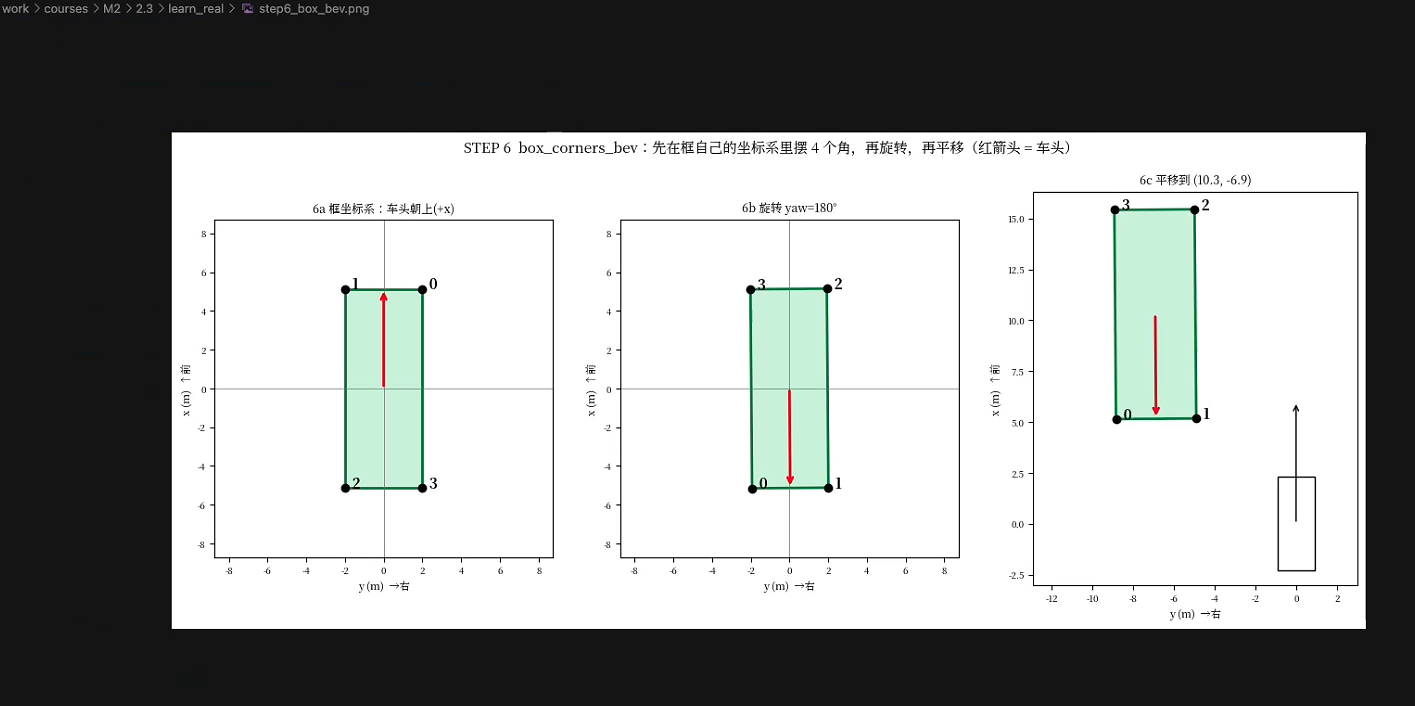
    STEP 6  一个 GT 框 → BEV 平面 4 个角点(旋转 + 平移)
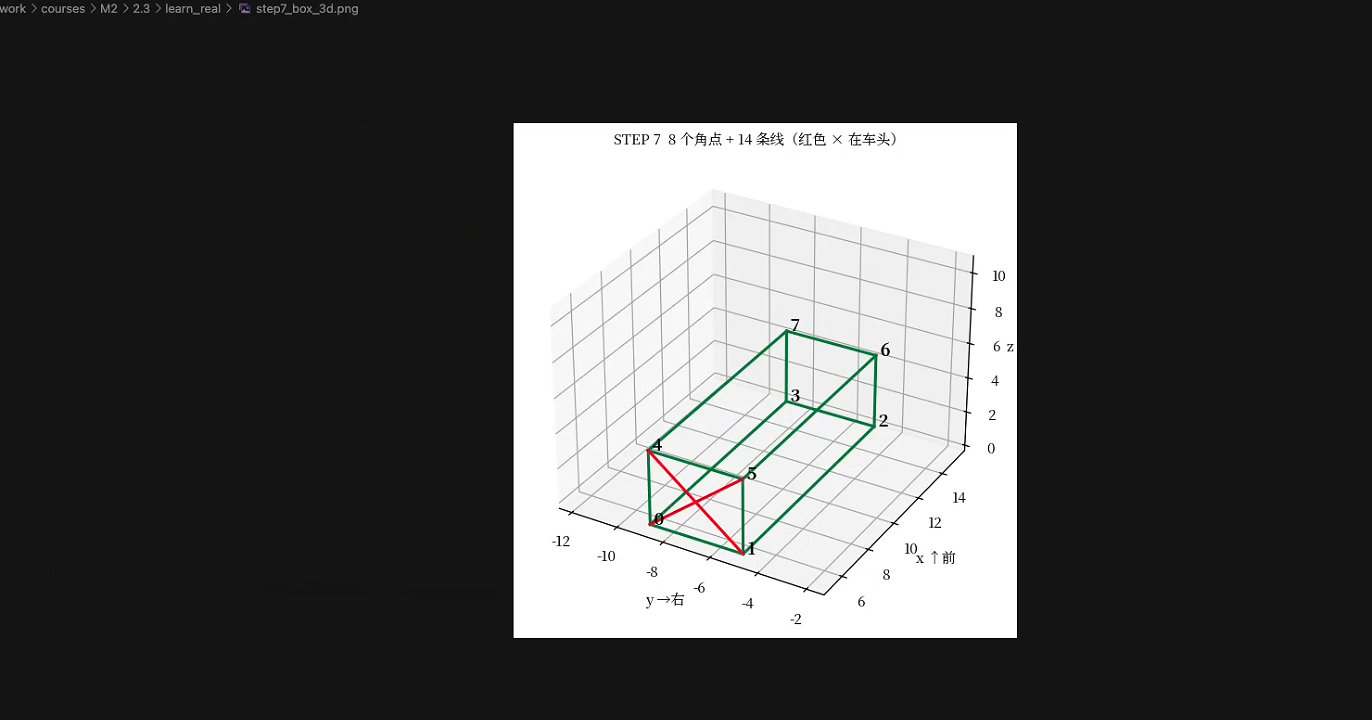
    STEP 7  4 个角点 → 8 个 3D 角点(加上高度)
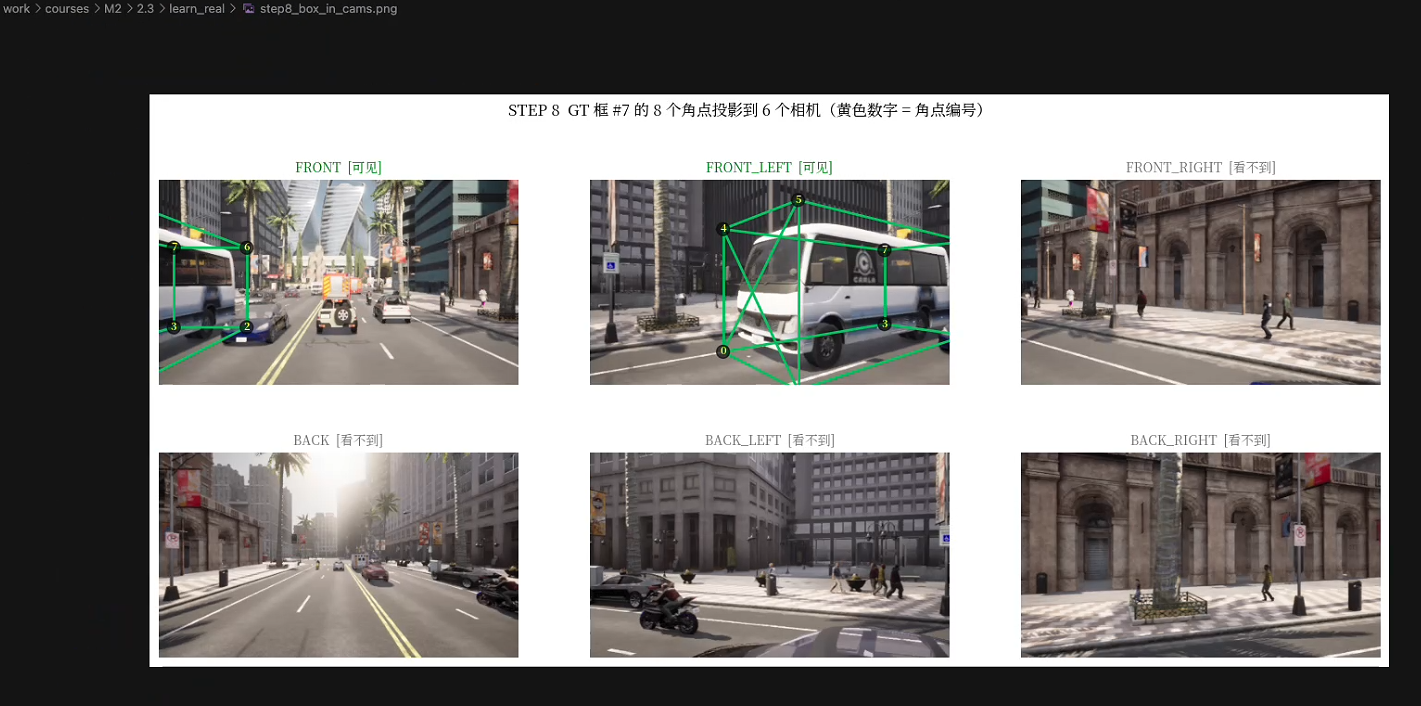
    STEP 8  8 个 3D 角点 → 投影到相机 → 连 14 条线(就是相机图上的绿框)
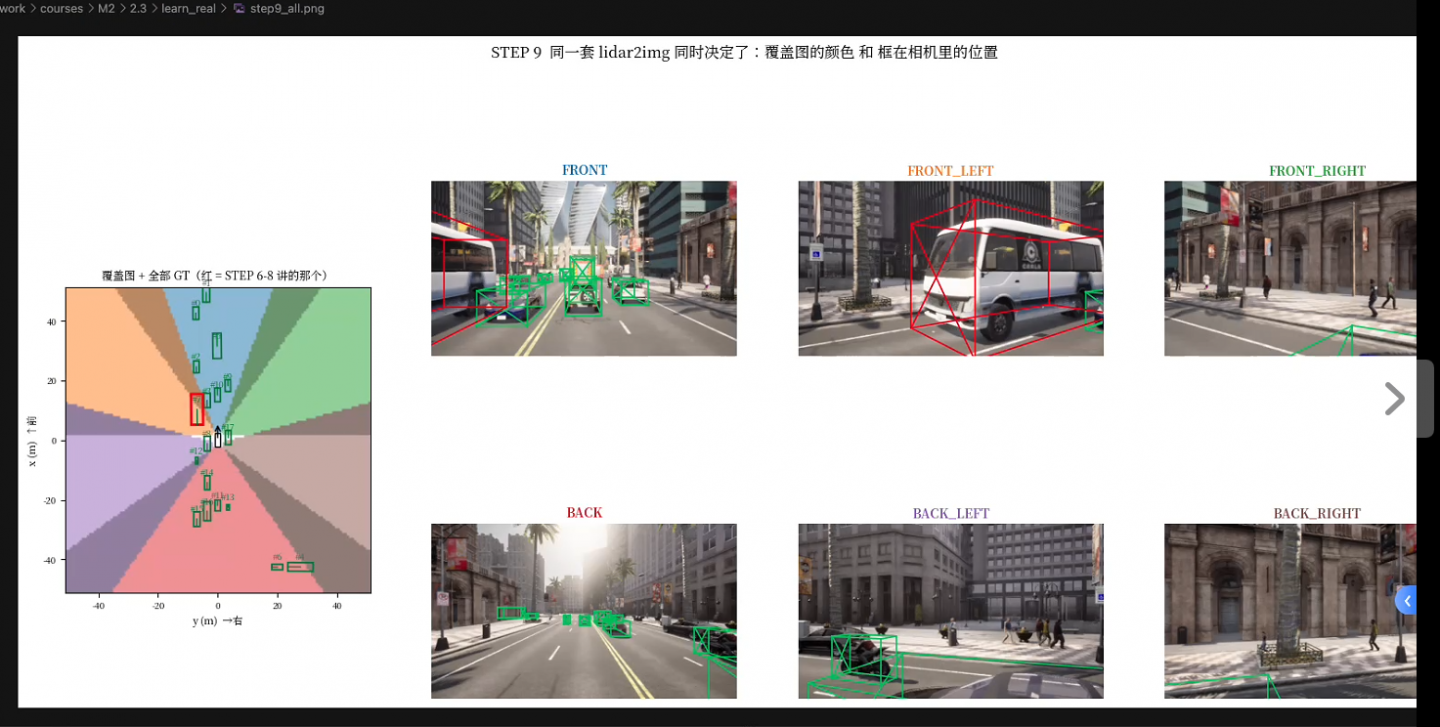
    STEP 9  全部合起来
"""

import argparse
import math
import os
import sys

import numpy as np
import matplotlib
matplotlib.use('Agg')
import matplotlib.pyplot as plt
from matplotlib.patches import Polygon, Patch

CAM_NAMES = ['FRONT', 'FRONT_LEFT', 'FRONT_RIGHT', 'BACK', 'BACK_LEFT', 'BACK_RIGHT']
CLS_NAMES = ['car', 'truck', 'ped', 'bike']
CMAP = plt.get_cmap('tab10')

# 12 条棱 + 车头面上的 2 条对角线(画成 ×,用来看朝向)
#   角点编号: 0,1,2,3 = 底面(0,1 在车头); 4,5,6,7 = 顶面(4,5 在车头)
EDGES = [(0, 1), (1, 2), (2, 3), (3, 0),        # 底面一圈
         (4, 5), (5, 6), (6, 7), (7, 4),        # 顶面一圈
         (0, 4), (1, 5), (2, 6), (3, 7),        # 4 根竖棱
         (0, 5), (1, 4)]                        # 车头的 ×

# ============================================================
#                         工具函数
# ============================================================
def hdr(t):
    print('\n' + '=' * 72 + '\n' + t + '\n' + '=' * 72)

def setup_font(path=None):
    from matplotlib import font_manager
    cands = [path] if path else []
    keys = ('notosanscjk', 'notoserifcjk', 'notosanssc', 'wqy', 'wenquanyi', 'simhei',
            'msyh', 'droidsansfallback', 'sourcehansans', 'pingfang', 'heiti', 'uming')
    if not path:
        for f in font_manager.findSystemFonts():
            n = os.path.basename(f).lower().replace('-', '').replace('_', '')
            if any(k in n for k in keys):
                cands.append(f)
    for f in cands:
        try:
            font_manager.fontManager.addfont(f)
            plt.rcParams['font.sans-serif'] = [font_manager.FontProperties(fname=f).get_name(),
                                               'DejaVu Sans']
            plt.rcParams['axes.unicode_minus'] = False
            return
        except Exception:
            continue
    print('[font] 没找到中文字体,图中中文会是方块(不影响学习)。'
          'sudo apt install fonts-noto-cjk && rm -rf ~/.cache/matplotlib')

def rot_z(yaw):
    """绕 z 轴旋转 yaw 弧度。在 x前/y右 的坐标系里,yaw>0 表示从 x 往 y(往右)转"""
    c, s = np.cos(yaw), np.sin(yaw)
    return np.array([[c, -s, 0], [s, c, 0], [0, 0, 1.]])

# 车体系(x前 y右 z上) → OpenCV 相机系(x右 y下 z前)
#   cv_x =  body_y   (右 → 右)
#   cv_y = -body_z   (上 → 下,取负)
#   cv_z =  body_x   (前 → 前,变成"深度")
A_BODY2CV = np.array([[0, 1, 0],
                      [0, 0, -1],
                      [1, 0, 0.]])

def build_lidar2img(pos, yaw_deg, W, H, fov_deg):
    """
    合成一个相机的 lidar2img(真实数据里这一步在 2.1/2.2 的数据集代码里做)
        lidar2img = K4 @ A4 @ ego2cam
    """
    f = W / (2 * np.tan(np.radians(fov_deg) / 2))
    K = np.array([[f, 0, W / 2], [0, f, H / 2], [0, 0, 1.]])
    R = rot_z(np.radians(yaw_deg))                  # 相机 → 自车 的旋转(相机的朝向)
    t = np.asarray(pos, float)                      # 相机在自车系里的位置
    ego2cam = np.eye(4)
    ego2cam[:3, :3] = R.T                           # 逆旋转
    ego2cam[:3, 3] = -R.T @ t                       # 逆平移
    A4 = np.eye(4); A4[:3, :3] = A_BODY2CV
    K4 = np.eye(4); K4[:3, :3] = K
    return K4 @ A4 @ ego2cam

def describe_camera(l2i, W):
    """
    从 lidar2img 反推相机参数(不需要知道数据集是怎么造的):
        lidar2img[:3,:3] = M = K · A · Rᵀ ,  lidar2img[:3,3] = t
      · 相机光心 C 满足 M·C + t = 0  →  C = -M⁻¹ t
      · M 的第 3 行 = 相机光轴方向(深度 d = 第3行·p + t₂)
      · cx = 第1行·光轴,fx = |第1行 - cx·光轴|(因为 K 无倾斜、R 正交)
    """
    M, t = l2i[:3, :3], l2i[:3, 3]
    C = -np.linalg.solve(M, t)
    s = np.linalg.norm(M[2])
    Mn = M / s
    fwd = Mn[2]
    cx = Mn[0] @ fwd; fx = np.linalg.norm(Mn[0] - cx * fwd)
    cy = Mn[1] @ fwd; fy = np.linalg.norm(Mn[1] - cy * fwd)
    return dict(pos=C, fwd=fwd,
                yaw=math.degrees(math.atan2(fwd[1], fwd[0])),
                pitch=math.degrees(math.asin(np.clip(fwd[2], -1, 1))),
                fx=fx, fy=fy, cx=cx, cy=cy,
                hfov=2 * math.degrees(math.atan(W / 2 / fx)), scale=s)

def project(pts3, l2i):
    """
    [P,3] 自车系的点 → 像素 (u,v) [P,2] 和深度 d [P]
        [u·d, v·d, d, 1]ᵀ = lidar2img @ [x, y, z, 1]ᵀ
        u = (u·d)/d,  v = (v·d)/d
    """
    ph = np.c_[pts3, np.ones(len(pts3))]            # 补 1 → 齐次坐标 [P,4]
    q = ph @ l2i.T                                  # 等价于对每个点做 l2i @ p
    d = q[:, 2]
    uv = q[:, :2] / np.clip(d, 1e-5, None)[:, None]
    return uv, d

def in_image(uv, d, W, H, dmin=1e-5):
    return (d > dmin) & (uv[:, 0] > 0) & (uv[:, 0] < W) & (uv[:, 1] > 0) & (uv[:, 1] < H)

def synthetic_image(l2i, W, H):
    """
    合成相机画面:对每个像素反向求出射线,和地面 z=0 求交,画出道路/车道线/棋盘格。
    (纯粹为了让合成模式的图像有透视感,真实数据模式不会用到)
    """
    M, t = l2i[:3, :3], l2i[:3, 3]
    Minv = np.linalg.inv(M)
    C = -Minv @ t
    u, v = np.meshgrid(np.arange(W) + 0.5, np.arange(H) + 0.5)
    pix = np.stack([u.ravel(), v.ravel(), np.ones(u.size)])
    dr = Minv @ pix                                 # 深度为 1 时,像素对应的 3D 方向
    with np.errstate(divide='ignore', invalid='ignore'):
        s = -C[2] / dr[2]
    hit = (dr[2] < -1e-9) & (s > 0) & (s < 120)
    X = C[0] + s * dr[0]; Y = C[1] + s * dr[1]
    img = np.zeros((u.size, 3))
    sky = np.clip(v.ravel() / H, 0, 1)[:, None]
    img[:] = np.array([0.55, 0.72, 0.92]) * (1 - 0.3 * sky) + 0.25 * sky
    g = hit
    checker = ((np.floor(X / 5) + np.floor(Y / 5)) % 2 == 0)
    img[g] = np.where(checker[g, None], [0.62, 0.66, 0.58], [0.55, 0.60, 0.52])
    road = g & (np.abs(Y) < 7) | g & (np.abs(X) < 7)
    img[road] = [0.38, 0.38, 0.40]
    line = g & (((np.abs(Y) < 0.12) & ((X % 6) < 3) & (np.abs(X) > 7)) |
                ((np.abs(X) < 0.12) & ((Y % 6) < 3) & (np.abs(Y) > 7)) |
                (np.abs(np.abs(Y) - 7) < 0.15) & (np.abs(X) > 7) |
                (np.abs(np.abs(X) - 7) < 0.15) & (np.abs(Y) > 7))
    img[line] = [0.95, 0.95, 0.95]
    fog = np.clip(s / 120, 0, 1)[:, None]
    img[g] = img[g] * (1 - 0.5 * fog[g]) + 0.5 * fog[g] * np.array([0.8, 0.85, 0.9])
    return img.reshape(H, W, 3)

def to_rgb(img):
    x = img.float().cpu().numpy().transpose(1, 2, 0)
    if x.min() < -0.1:
        x = x * np.array([0.229, 0.224, 0.225]) + np.array([0.485, 0.456, 0.406])
    elif x.max() > 1.5:
        x = x / 255.0
    return np.clip(x, 0, 1)

def setup_bev(ax, lim, title=''):
    """
    BEV 画图约定(和 vis_bev.py 完全一致):
        画布横轴 = 自车 y(向右为正)
        画布纵轴 = 自车 x(向上 = 车头前方)
      所以画一个自车系的点 (x, y) 时,要写 ax.plot(y, x) —— 顺序是反的!
    """
    if np.isscalar(lim):
        lim = (-lim, lim, -lim, lim)
    ax.set_xlim(lim[0], lim[1]); ax.set_ylim(lim[2], lim[3])
    ax.set_aspect('equal')
    ax.set_xlabel('y (m)  →右', fontsize=8); ax.set_ylabel('x (m)  ↑前', fontsize=8)
    ax.tick_params(labelsize=7)
    if title:
        ax.set_title(title, fontsize=9)

def draw_ego(ax):
    ax.add_patch(Polygon([[-0.9, 2.3], [0.9, 2.3], [0.9, -2.3], [-0.9, -2.3]],
                         closed=True, fc='white', ec='black', lw=1, zorder=5))
    ax.annotate('', xy=(0, 6), xytext=(0, 0),
                arrowprops=dict(arrowstyle='->', color='black'), zorder=6)

def box_corners_bev(box):
    x, y, _, l, w, _, yaw = box[:7]
    local = np.array([[l / 2, w / 2], [l / 2, -w / 2], [-l / 2, -w / 2], [-l / 2, w / 2]])
    c, s = np.cos(yaw), np.sin(yaw)
    R = np.array([[c, -s], [s, c]])
    return local @ R.T + np.array([x, y])

def box_corners_3d(box, z_bottom=False):
    x, y, z, l, w, h, yaw = box[:7]
    bev = box_corners_bev(box)
    z0 = z if z_bottom else z - h / 2
    return np.vstack([np.c_[bev, np.full(4, z0)], np.c_[bev, np.full(4, z0 + h)]])

def draw_box_on_cam(ax, c3, l2i, W, H, color, lw=1.2, label_corners=False):
    uv, d = project(c3, l2i)
    if not (in_image(uv, d, W, H, dmin=1.0)).any():
        return False
    for i, j in EDGES:
        if d[i] > 1.0 and d[j] > 1.0:
            ax.plot(uv[[i, j], 0], uv[[i, j], 1], color=color, lw=lw)
    if label_corners:
        for k in range(8):
            if d[k] > 1.0 and 0 < uv[k, 0] < W and 0 < uv[k, 1] < H:
                ax.text(uv[k, 0], uv[k, 1], str(k), color='yellow', fontsize=8,
                        fontweight='bold', ha='center', va='center',
                        bbox=dict(boxstyle='circle,pad=0.1', fc='black', alpha=0.6))
    return True

# ============================================================
#                          主流程
# ============================================================
def main():
    ap = argparse.ArgumentParser()
    ap.add_argument('--root', default=None, help='不填 = 合成模式')
    ap.add_argument('--split', default='val')
    ap.add_argument('--frame', type=int, default=0)
    ap.add_argument('--img-w', type=int, default=448)
    ap.add_argument('--img-h', type=int, default=256)
    ap.add_argument('--bev-size', type=int, default=128)
    ap.add_argument('--pc-range', type=float, default=51.2)
    ap.add_argument('--cell', type=float, nargs=2, default=[20.0, 5.0],
                    help='STEP 3 追踪哪个格子 (x y),单位米')
    ap.add_argument('--box', type=int, default=-1, help='STEP 6-8 讲解哪个框(-1=自动选最近的)')
    ap.add_argument('--cam-names', default=','.join(CAM_NAMES))
    ap.add_argument('--z-bottom', action='store_true')
    ap.add_argument('--out', default='./learn_out')
    ap.add_argument('--pause', action='store_true', help='每一步进入 pdb 断点')
    ap.add_argument('--font', default=None)
    args = ap.parse_args()
    setup_font(args.font)
    os.makedirs(args.out, exist_ok=True)
    PAUSE = args.pause
    cam_names = args.cam_names.split(',')
    pc, bev = args.pc_range, args.bev_size
    np.set_printoptions(precision=2, suppress=True, linewidth=120)

    # ---------------------------------------------------------------
    # STEP 0  读数据:拿到 6 张图、6 个 lidar2img、M 个 GT 框
    # ---------------------------------------------------------------
    hdr('STEP 0  读数据')
    if args.root:
        sys.path.insert(0, os.getcwd())
        import torch
        from torch.utils.data import DataLoader, Subset
        from bev_dataset import BEVDataset, bev_collate_fn
        ds = BEVDataset(args.root, args.split, img_size=(args.img_w, args.img_h),
                        pc_range=pc, augment=False)
        batch = next(iter(DataLoader(Subset(ds, [args.frame]), batch_size=1,
                                     collate_fn=bev_collate_fn)))
        imgs = [to_rgb(x) for x in batch['imgs'][0]]
        l2i = batch['lidar2img'][0].numpy().astype(np.float64)
        gt_boxes = batch['gt_boxes'][0].numpy().reshape(-1, 7).astype(np.float64)
        gt_labels = batch['gt_labels'][0].numpy().reshape(-1).astype(int)
        print(f'数据来源: {args.root} [{args.split}] 第 {args.frame} 帧')
    else:
        W, H = args.img_w, args.img_h
        #        名字           位置 (x, y, z) 米     yaw(°)  水平视场角(°)
        rig = [('FRONT',       (1.5,  0.0, 1.6),    0,   70),
               ('FRONT_LEFT',  (1.3, -0.5, 1.6),  -55,   70),
               ('FRONT_RIGHT', (1.3,  0.5, 1.6),   55,   70),
               ('BACK',        (-1.5, 0.0, 1.6),  180,  110),
               ('BACK_LEFT',   (-1.3, -0.5, 1.6), -110,  70),
               ('BACK_RIGHT',  (-1.3,  0.5, 1.6),  110,  70)]
        l2i = np.stack([build_lidar2img(p, y, W, H, f) for _, p, y, f in rig])
        imgs = [synthetic_image(m, W, H) for m in l2i]
        #                   x     y    z    l    w    h    yaw         label
        gt = np.array([[ 12.0,  3.5, 0.75, 4.5, 1.9, 1.5, 0.0,        0],
                       [ 28.0, -3.5, 0.75, 4.6, 1.9, 1.5, math.pi,    0],
                       [  9.0,-15.0, 1.50,10.0, 2.5, 3.0, math.pi/2,  1],
                       [-11.0,  3.5, 0.85, 5.5, 2.1, 1.7, 0.0,        0],
                       [ -4.0,  9.0, 0.85, 0.6, 0.6, 1.7, 0.0,        2],
                       [ 35.0, 18.0, 0.75, 4.5, 1.9, 1.5, math.pi/2,  0],
                       [-25.0, -3.5, 0.75, 4.5, 1.9, 1.5, math.pi,    0]])
        gt_boxes, gt_labels = gt[:, :7], gt[:, 7].astype(int)
        print('合成模式:6 相机环视 rig + 7 个 GT 框(不需要数据集)')
    N = len(l2i)
    H_img, W_img = imgs[0].shape[:2]
    print(f'imgs      : {N} 张, 每张 {H_img}×{W_img}×3')
    print(f'lidar2img : {l2i.shape}   ← 每个相机一个 4×4 矩阵')
    print(f'gt_boxes  : {gt_boxes.shape}  ← 每行 (x, y, z, l, w, h, yaw),自车坐标系')
    print(f'\nlidar2img[0]({cam_names[0]})=\n{l2i[0]}')
    if PAUSE: breakpoint()   # 【断点 0】 试试: p l2i.shape / p gt_boxes[:3]

    # ---------------------------------------------------------------
    # STEP 1  读懂 lidar2img:反推出每个相机的安装位置和朝向
    # ---------------------------------------------------------------
    hdr('STEP 1  从 lidar2img 反推相机(检查外参/内参对不对的最好办法)')
    cams = [describe_camera(l2i[n], W_img) for n in range(N)]
    print(f'{"相机":<12}{"位置 x,y,z (m)":<24}{"yaw°":>7}{"pitch°":>8}'
          f'{"fx":>8}{"cx":>8}{"cy":>8}{"水平FOV°":>10}')
    for n, c in enumerate(cams):
        p = c['pos']
        print(f'{cam_names[n]:<12}({p[0]:6.2f},{p[1]:6.2f},{p[2]:5.2f})    '
              f'{c["yaw"]:7.1f}{c["pitch"]:8.1f}{c["fx"]:8.1f}{c["cx"]:8.1f}'
              f'{c["cy"]:8.1f}{c["hfov"]:10.1f}')
    print('\n解读: yaw=0 朝正前,yaw<0 朝左,yaw>0 朝右,±180 朝后;'
          'cx≈W/2、cy≈H/2 说明内参缩放正确')

    fig, ax = plt.subplots(figsize=(7, 7))
    for n, c in enumerate(cams):
        p, yaw, hf = c['pos'], math.radians(c['yaw']), math.radians(c['hfov'])
        for a in (yaw - hf / 2, yaw + hf / 2):
            ax.plot([p[1], p[1] + 45 * math.sin(a)], [p[0], p[0] + 45 * math.cos(a)],
                    color=CMAP(n), lw=1)
        th = np.linspace(yaw - hf / 2, yaw + hf / 2, 30)
        wedge = np.c_[np.r_[p[1], p[1] + 45 * np.sin(th)], np.r_[p[0], p[0] + 45 * np.cos(th)]]
        ax.add_patch(Polygon(wedge, closed=True, fc=CMAP(n), alpha=0.18, ec='none'))
        ax.annotate('', xy=(p[1] + 8 * math.sin(yaw), p[0] + 8 * math.cos(yaw)),
                    xytext=(p[1], p[0]), arrowprops=dict(arrowstyle='->', color=CMAP(n), lw=2))
        ax.text(p[1] + 30 * math.sin(yaw), p[0] + 30 * math.cos(yaw),
                f'{cam_names[n]}\nyaw={c["yaw"]:.0f}° FOV={c["hfov"]:.0f}°',
                color=CMAP(n), fontsize=8, ha='center', fontweight='bold')
    draw_ego(ax)
    setup_bev(ax, 50, 'STEP 1  相机装在哪、朝哪看(全部从 lidar2img 反推)')
    fig.savefig(f'{args.out}/step1_rig.png', dpi=110, bbox_inches='tight'); plt.close(fig)
    if PAUSE: breakpoint()   # 【断点 1】 试试: pp cams[0]

    # ---------------------------------------------------------------
    # STEP 2  BEV 网格(和 MiniBEVFormer._make_coords 一模一样)
    # ---------------------------------------------------------------
    hdr('STEP 2  BEV 网格坐标')
    xs = np.linspace(pc, -pc, bev)          # 行:从上(前方 +51.2) 到下(后方 -51.2)
    ys = np.linspace(-pc, pc, bev)          # 列:从左(-51.2) 到右(+51.2)
    gx, gy = np.meshgrid(xs, ys, indexing='ij')
    coords = np.stack([gx.ravel(), gy.ravel()], 1)     # [bev*bev, 2]
    P = len(coords)
    print(f'coords.shape = {coords.shape}   ({bev}×{bev} 个格子,每个存 (x, y))')
    print('扁平索引 i  ↔  (行, 列) = divmod(i, bev)')
    for i in [0, 1, bev - 1, bev, P // 2 + bev // 2, P - 1]:
        r, c = divmod(i, bev)
        print(f'  coords[{i:5d}] = ({coords[i,0]:6.2f}, {coords[i,1]:6.2f})   行 {r:3d} 列 {c:3d}')
    print(f'格子边长 ≈ {2*pc/(bev-1):.3f} m')
    if PAUSE: breakpoint()   # 【断点 2】 试试: p coords[:3] / p gx[0,:3] / p gy[:3,0]

    # ---------------------------------------------------------------
    # STEP 3  追踪一根柱子:一个格子 × 4 个高度 → 6 个相机
    # ---------------------------------------------------------------
    hdr(f'STEP 3  追踪一根柱子:格子 ({args.cell[0]}, {args.cell[1]})')
    idx = int(np.argmin(((coords - np.array(args.cell)) ** 2).sum(1)))
    r0, c0 = divmod(idx, bev)
    cell = coords[idx]
    zs = np.linspace(-2.0, 4.0, 4)                      # 和 SpatialCrossAttention 相同
    pillar = np.c_[np.repeat(cell[None], 4, 0), zs]     # [4,3]
    print(f'最近的格子: 索引 {idx} (行 {r0}, 列 {c0}),中心 = ({cell[0]:.2f}, {cell[1]:.2f})')
    print(f'柱子上的 4 个点 (x, y, z):\n{pillar}\n')
    print(f'{"相机":<12}{"z":>5}{"u·d":>10}{"v·d":>10}{"d(深度)":>10}{"u":>9}{"v":>9}  有效?')
    pillar_proj = []
    for n in range(N):
        ph = np.c_[pillar, np.ones(4)]
        q = ph @ l2i[n].T                               # 【核心】 4×4 矩阵乘
        uv, d = project(pillar, l2i[n])
        ok = in_image(uv, d, W_img, H_img)
        pillar_proj.append((uv, d, ok))
        for k in range(4):
            reason = '✓' if ok[k] else ('✗ 在相机背后(d≤0)' if d[k] <= 0 else '✗ 落在图像外')
            uvs = (f'{uv[k,0]:9.1f}{uv[k,1]:9.1f}' if d[k] > 0 else f'{"—":>9}{"—":>9}')
            print(f'{cam_names[n]:<12}{zs[k]:5.1f}{q[k,0]:10.1f}{q[k,1]:10.1f}{q[k,2]:10.2f}'
                  f'{uvs}  {reason}')
    print('\n→ 只要某相机里 4 个点有一个 ✓,就说这个格子被该相机"覆盖"')

    fig = plt.figure(figsize=(18, 7))
    axb = fig.add_subplot(1, 4, 1)
    for n, c in enumerate(cams):
        p, yaw, hf = c['pos'], math.radians(c['yaw']), math.radians(c['hfov'])
        th = np.linspace(yaw - hf / 2, yaw + hf / 2, 30)
        wedge = np.c_[np.r_[p[1], p[1] + 60 * np.sin(th)], np.r_[p[0], p[0] + 60 * np.cos(th)]]
        axb.add_patch(Polygon(wedge, closed=True, fc=CMAP(n), alpha=0.15, ec=CMAP(n), lw=0.5))
    axb.plot(cell[1], cell[0], marker='*', ms=16, color='red', zorder=10)
    for n in range(N):
        if pillar_proj[n][2].any():
            axb.plot([cams[n]['pos'][1], cell[1]], [cams[n]['pos'][0], cell[0]],
                     '--', color=CMAP(n), lw=1.5)
    draw_ego(axb)
    setup_bev(axb, 40, f'俯视:★ = 格子 ({cell[0]:.1f}, {cell[1]:.1f})\n虚线 = 能看到它的相机')
    for n in range(N):
        ax = fig.add_subplot(2, 4, [2, 3, 4, 6, 7, 8][n])
        ax.imshow(imgs[n])
        uv, d, ok = pillar_proj[n]
        for k in range(4):
            if ok[k]:
                ax.plot(uv[k, 0], uv[k, 1], 'o', ms=7, mfc=plt.cm.viridis(k / 3), mec='white')
                ax.text(uv[k, 0] + 8, uv[k, 1], f'z={zs[k]:.0f}', color='white', fontsize=7,
                        bbox=dict(fc='black', alpha=0.5, pad=1))
        if ok.any():
            ax.plot(uv[ok, 0], uv[ok, 1], '-', color='red', lw=1)
        ax.set_xlim(0, W_img); ax.set_ylim(H_img, 0)
        ax.set_title(f'{cam_names[n]}   有效点 {ok.sum()}/4', fontsize=9,
                     color='green' if ok.any() else 'gray')
        ax.axis('off')
    fig.suptitle('STEP 3  一根柱子(同一个 x,y,4 个高度)投影到 6 个相机 —— '
                 'SpatialCrossAttention 就是在这些点上取特征', fontsize=11)
    fig.savefig(f'{args.out}/step3_one_pillar.png', dpi=100, bbox_inches='tight'); plt.close(fig)
    if PAUSE: breakpoint()   # 【断点 3】 试试: p pillar / p l2i[0] @ np.r_[pillar[1], 1]

    # ---------------------------------------------------------------
    # STEP 4  全网格覆盖:所有格子 × 4 高度 × 6 相机 一次算完
    # ---------------------------------------------------------------
    hdr('STEP 4  全网格覆盖 cov[相机, 格子]')
    Z = len(zs)
    pts = np.c_[np.repeat(coords, Z, axis=0), np.tile(zs, P)]     # [P*Z, 3]
    #   顺序: 格子0的z0,z1,z2,z3, 格子1的z0..z3, ...  (和 SCA 里 ref.reshape(-1,3) 一致)
    ph = np.c_[pts, np.ones(P * Z)]                                # [P*Z, 4]
    q = np.einsum('nij,pj->npi', l2i, ph)                         # [N, P*Z, 4]
    d = q[..., 2]
    uv = q[..., :2] / np.clip(d, 1e-5, None)[..., None]
    valid = ((d > 1e-5) & (uv[..., 0] > 0) & (uv[..., 0] < W_img)
             & (uv[..., 1] > 0) & (uv[..., 1] < H_img))           # [N, P*Z]
    valid = valid.reshape(N, P, Z)                                 # [N, P, Z]
    cov = valid.any(axis=2)                                        # [N, P]  任一高度有效即可
    print(f'pts   {pts.shape}  →  q {q.shape}  →  valid {valid.shape}  →  cov {cov.shape}')
    print(f'自检: STEP 3 那个格子的 cov[:, {idx}] = {cov[:, idx].astype(int)}'
          f'  (应与上表每个相机是否有 ✓ 一致)')
    for n in range(N):
        print(f'  {cam_names[n]:<12} 覆盖 {100*cov[n].mean():5.1f}% 的格子')
    cnt = cov.sum(0)
    for k in range(N + 1):
        if (cnt == k).any():
            print(f'  被 {k} 个相机看到: {100*(cnt==k).mean():5.1f}%'
                  + ('   ← 盲区(白色)' if k == 0 else '   ← 重叠区(深色)' if k >= 2 else ''))

    fig, axs = plt.subplots(2, 3, figsize=(13, 9))
    for n in range(N):
        ax = axs.flat[n]
        ax.imshow(cov[n].reshape(bev, bev), extent=[-pc, pc, -pc, pc],
                  cmap=matplotlib.colors.ListedColormap(['white', CMAP(n)]), vmin=0, vmax=1)
        draw_ego(ax)
        setup_bev(ax, pc, f'cov[{n}]  {cam_names[n]}  ({100*cov[n].mean():.1f}%)')
    fig.suptitle('STEP 4  每个相机单独的覆盖掩码(True=这个格子投影后落在该相机图像里)')
    fig.savefig(f'{args.out}/step4_per_camera.png', dpi=100, bbox_inches='tight'); plt.close(fig)
    if PAUSE: breakpoint()   # 【断点 4】 试试: p valid[:, idx] / p cov.sum(0)[:10]

    # ---------------------------------------------------------------
    # STEP 5  上色:cov → 覆盖图(vis_bev.py 面板 ① 的底图)
    # ---------------------------------------------------------------
    hdr('STEP 5  cov → RGB 覆盖图')
    rgb = np.ones((P, 3))                                          # 5a 全白
    snap = [rgb.copy()]
    for n in range(N):                                             # 5b 每个相机涂自己的浅色
        rgb[cov[n]] = np.array(CMAP(n)[:3]) * 0.45 + 0.55          #    后涂的会盖住先涂的
        if n == 0:
            snap.append(rgb.copy())
    snap.append(rgb.copy())
    overlap = cnt >= 2
    rgb[overlap] *= 0.75                                           # 5c 重叠区压暗 25%
    snap.append(rgb.copy())
    cov_img = rgb.reshape(bev, bev, 3)                             # 5d [P,3] → [bev,bev,3]
    print(f'rgb {rgb.shape} → reshape → cov_img {cov_img.shape}')
    print(f'cov_img[0, 0]   (左上角) 对应 coords[0]   = {coords[0]}  前方最远、最左')
    print(f'cov_img[-1, -1] (右下角) 对应 coords[-1]  = {coords[-1]}  后方最远、最右')
    print('imshow(..., extent=[-pc, pc, -pc, pc]) 默认 origin="upper":'
          '第 0 行画在最上面 (x=+pc),第 0 列画在最左边 (y=-pc)')

    fig, axs = plt.subplots(1, 4, figsize=(20, 5.4))
    titles = ['5a 全白(没有相机)', f'5b 只涂了 {cam_names[0]}',
              '5b 6 个相机都涂完', '5c 重叠区压暗 → 最终覆盖图 + GT 框']
    for ax, s, t in zip(axs, snap, titles):
        ax.imshow(s.reshape(bev, bev, 3), extent=[-pc, pc, -pc, pc])
        draw_ego(ax); setup_bev(ax, pc, t)
    for b, lb in zip(gt_boxes, gt_labels):
        c = box_corners_bev(b)
        axs[3].add_patch(Polygon(c[:, ::-1], closed=True, fill=False, ec='#15803d', lw=1.5))
    axs[3].legend(handles=[Patch(color=CMAP(n), label=cam_names[n]) for n in range(N)],
                  fontsize=6, loc='lower left')
    fig.savefig(f'{args.out}/step5_coverage.png', dpi=100, bbox_inches='tight'); plt.close(fig)
    if PAUSE: breakpoint()   # 【断点 5】 试试: p cov_img[0,0] / p cov_img[bev//2, bev//2]

    # ---------------------------------------------------------------
    # STEP 6  一个 GT 框 → BEV 平面 4 个角点
    # ---------------------------------------------------------------
    inr = (np.abs(gt_boxes[:, 0]) < pc) & (np.abs(gt_boxes[:, 1]) < pc)
    if args.box >= 0:
        bi = args.box
    else:   # 自动选:在 FRONT 相机里可见、离自车最近的框
        dist = np.hypot(gt_boxes[:, 0], gt_boxes[:, 1]) + 1e3 * ~inr
        front_vis = np.array([in_image(*project(box_corners_3d(b, args.z_bottom), l2i[0]),
                                       W_img, H_img, 1.0).sum() >= 4 for b in gt_boxes])
        dist = dist + 1e3 * ~front_vis if front_vis.any() else dist
        dist[dist < 3] += 1e3          # 跳过可能是自车的框
        bi = int(np.argmin(dist))
    box = gt_boxes[bi]
    x, y, z, l, w, h, yaw = box
    hdr(f'STEP 6  GT 框 #{bi} → BEV 4 个角点')
    print(f'box = (x={x:.2f}, y={y:.2f}, z={z:.2f}, l={l:.2f}, w={w:.2f}, h={h:.2f}, '
          f'yaw={yaw:.3f} rad = {math.degrees(yaw):.1f}°)  类别 {gt_labels[bi]}')
    local = np.array([[l/2, w/2], [l/2, -w/2], [-l/2, -w/2], [-l/2, w/2]])
    c_, s_ = np.cos(yaw), np.sin(yaw)
    R2 = np.array([[c_, -s_], [s_, c_]])
    rotated = local @ R2.T
    world = rotated + np.array([x, y])
    print('\n6a 框自己的坐标系(车头朝 +x,中心在原点):')
    for k, nm in enumerate(['前右', '前左', '后左', '后右']):
        print(f'   角点{k} ({nm}) = ({local[k,0]:6.2f}, {local[k,1]:6.2f})')
    print(f'\n6b 旋转矩阵 R(yaw) =\n{R2}')
    print('   rotated = local @ R.T')
    print(rotated)
    print(f'\n6c 平移到 (x, y) = ({x:.2f}, {y:.2f}):  world = rotated + [x, y]')
    print(world)
    assert np.allclose(world, box_corners_bev(box))

    fig, axs = plt.subplots(1, 3, figsize=(16, 5.5))
    R0 = max(l, w) * 0.85
    for ax, pts2, t in [(axs[0], local, '6a 框坐标系:车头朝上(+x)'),
                        (axs[1], rotated, f'6b 旋转 yaw={math.degrees(yaw):.0f}°'),
                        (axs[2], world, f'6c 平移到 ({x:.1f}, {y:.1f})')]:
        ax.add_patch(Polygon(pts2[:, ::-1], closed=True, fc='#22c55e33', ec='#15803d', lw=2))
        ctr = pts2.mean(0); front = (pts2[0] + pts2[1]) / 2
        ax.annotate('', xy=(front[1], front[0]), xytext=(ctr[1], ctr[0]),
                    arrowprops=dict(arrowstyle='->', color='red', lw=2))
        for k in range(4):
            ax.plot(pts2[k, 1], pts2[k, 0], 'o', color='black')
            ax.text(pts2[k, 1], pts2[k, 0], f'  {k}', fontsize=11, fontweight='bold')
        if ax is axs[2]:
            draw_ego(ax)
            lim = max(abs(x), abs(y)) + 5
            setup_bev(ax, (min(-3, y - 6), max(3, y + 6), min(-3, x - 6), max(3, x + 6)), t)
        else:
            ax.axhline(0, color='gray', lw=0.5); ax.axvline(0, color='gray', lw=0.5)
            setup_bev(ax, R0, t)
    fig.suptitle('STEP 6  box_corners_bev:先在框自己的坐标系里摆 4 个角,再旋转,再平移'
                 '(红箭头 = 车头)', fontsize=11)
    fig.savefig(f'{args.out}/step6_box_bev.png', dpi=100, bbox_inches='tight'); plt.close(fig)
    if PAUSE: breakpoint()   # 【断点 6】 试试: p local / p R2 / p world

    # ---------------------------------------------------------------
    # STEP 7  4 个 BEV 角点 → 8 个 3D 角点
    # ---------------------------------------------------------------
    hdr('STEP 7  加上高度 → 8 个 3D 角点')
    z0 = z if args.z_bottom else z - h / 2
    c3 = np.vstack([np.c_[world, np.full(4, z0)], np.c_[world, np.full(4, z0 + h)]])
    print(f'z 是{"底面" if args.z_bottom else "中心"}高度 → 底面 z0 = {z0:.2f},顶面 = {z0+h:.2f}')
    for k in range(8):
        print(f'   角点{k} = ({c3[k,0]:7.2f}, {c3[k,1]:7.2f}, {c3[k,2]:5.2f})   '
              f'{"底" if k < 4 else "顶"}面 {"车头" if k % 4 < 2 else "车尾"}')
    assert np.allclose(c3, box_corners_3d(box, args.z_bottom))

    fig = plt.figure(figsize=(7, 6))
    ax = fig.add_subplot(projection='3d')
    #  画 3D 时用 (y, x, z) 的顺序:y 向右、x 向前、z 向上,和 BEV 图方向一致
    for i, j in EDGES:
        ax.plot(c3[[i, j], 1], c3[[i, j], 0], c3[[i, j], 2],
                color='red' if (i, j) in [(0, 5), (1, 4)] else '#15803d', lw=2)
    for k in range(8):
        ax.text(c3[k, 1], c3[k, 0], c3[k, 2], f' {k}', fontsize=12, fontweight='bold')
    ax.set_xlabel('y →右'); ax.set_ylabel('x ↑前'); ax.set_zlabel('z ↑上')
    m = max(l, w, h) / 2 + 0.5
    ax.set_xlim(y - m, y + m); ax.set_ylim(x - m, x + m); ax.set_zlim(z0 - 0.3, z0 + 2 * m - 0.3)
    ax.set_title('STEP 7  8 个角点 + 14 条线(红色 × 在车头)', fontsize=10)
    fig.savefig(f'{args.out}/step7_box_3d.png', dpi=110, bbox_inches='tight'); plt.close(fig)
    if PAUSE: breakpoint()   # 【断点 7】 试试: p c3

    # ---------------------------------------------------------------
    # STEP 8  8 个 3D 角点 → 投影到每个相机 → 连线
    # ---------------------------------------------------------------
    hdr('STEP 8  8 个角点投影到 6 个相机')
    seen = []
    for n in range(N):
        uv8, d8 = project(c3, l2i[n])
        ok8 = in_image(uv8, d8, W_img, H_img, dmin=1.0)
        drawn = ok8.any()
        seen.append(drawn)
        print(f'\n[{cam_names[n]}]  {"→ 画" if drawn else "→ 不画"}'
              f'({ok8.sum()}/8 个角点在图像内)')
        if drawn or (d8 > 0).any():
            for k in range(8):
                tag = '✓' if ok8[k] else ('背后' if d8[k] <= 1.0 else '图外')
                print(f'   角点{k}: d={d8[k]:7.2f}  u={uv8[k,0]:8.1f}  v={uv8[k,1]:8.1f}  {tag}')
    print('\n规则: ① 只要有 1 个角点在图内且 d>1m,这个相机就画这个框'
          '\n      ② 每条线两端 d 都 >1m 才画(太近/背后的点透视后会飞到天边)'
          '\n      ③ 线段伸出图像的部分由 set_xlim/set_ylim 自动裁掉')

    fig, axs = plt.subplots(2, 3, figsize=(17, 7))
    for n in range(N):
        ax = axs.flat[n]
        ax.imshow(imgs[n])
        draw_box_on_cam(ax, c3, l2i[n], W_img, H_img, '#22c55e', lw=2, label_corners=True)
        ax.set_xlim(0, W_img); ax.set_ylim(H_img, 0); ax.axis('off')
        ax.set_title(f'{cam_names[n]}  {"[可见]" if seen[n] else "[看不到]"}', fontsize=10,
                     color='green' if seen[n] else 'gray')
    fig.suptitle(f'STEP 8  GT 框 #{bi} 的 8 个角点投影到 6 个相机(黄色数字 = 角点编号)')
    fig.savefig(f'{args.out}/step8_box_in_cams.png', dpi=100, bbox_inches='tight'); plt.close(fig)
    if PAUSE: breakpoint()   # 【断点 8】 试试: p project(c3, l2i[0])

    # ---------------------------------------------------------------
    # STEP 9  全部合起来(= vis_bev.py 的面板 ① + 6 路相机)
    # ---------------------------------------------------------------
    hdr('STEP 9  全部 GT 框 → 覆盖图 + 6 路相机')
    fig = plt.figure(figsize=(20, 9))
    axb = fig.add_subplot(1, 4, 1)
    axb.imshow(cov_img, extent=[-pc, pc, -pc, pc])
    for k, (b, lb) in enumerate(zip(gt_boxes, gt_labels)):
        c = box_corners_bev(b)
        axb.add_patch(Polygon(c[:, ::-1], closed=True, fill=False,
                              ec='red' if k == bi else '#15803d', lw=2 if k == bi else 1.3))
        fr = (c[0] + c[1]) / 2
        axb.plot([b[1], fr[1]], [b[0], fr[0]], color='#15803d', lw=1)
        axb.text(b[1], b[0] + 2.5, f'#{k}', fontsize=7, color='#15803d', ha='center')
    draw_ego(axb)
    setup_bev(axb, pc, '覆盖图 + 全部 GT(红 = STEP 6-8 讲的那个)')
    for n in range(N):
        ax = fig.add_subplot(2, 4, [2, 3, 4, 6, 7, 8][n])
        ax.imshow(imgs[n])
        for k, b in enumerate(gt_boxes):
            draw_box_on_cam(ax, box_corners_3d(b, args.z_bottom), l2i[n], W_img, H_img,
                            'red' if k == bi else '#22c55e')
        ax.set_xlim(0, W_img); ax.set_ylim(H_img, 0); ax.axis('off')
        ax.set_title(cam_names[n], fontsize=10, color=CMAP(n), fontweight='bold')
    fig.suptitle('STEP 9  同一套 lidar2img 同时决定了:覆盖图的颜色 和 框在相机里的位置')
    fig.savefig(f'{args.out}/step9_all.png', dpi=100, bbox_inches='tight'); plt.close(fig)
    print(f'\n全部完成,图片在 {os.path.abspath(args.out)}/')

if __name__ == '__main__':
    main()
执行结果:
(ad) leoking@leoking-desktop:~/carla/work/courses/M2/2.3$ python learn_projection.py --root ../dataset_v4 --split val --frame 8 --out ./learn_real

========================================================================
STEP 0  读数据
========================================================================
[val] 1 场景, 50 帧
数据来源: ../dataset_v4 [val] 第 8 帧
imgs      : 6 张, 每张 256×448×3
lidar2img : (6, 4, 4)   ← 每个相机一个 4×4 矩阵
gt_boxes  : (18, 7)  ← 每行 (x, y, z, l, w, h, yaw),自车坐标系

lidar2img[0](FRONT)=
[[ 224.    319.91    0.   -336.  ]
 [ 128.      0.   -324.98  587.96]
 [   1.      0.      0.     -1.5 ]
 [   0.      0.      0.      1.  ]]

========================================================================
STEP 1  从 lidar2img 反推相机(检查外参/内参对不对的最好办法)
========================================================================
相机          位置 x,y,z (m)               yaw°  pitch°      fx      cx      cy    水平FOV°
FRONT       (  1.50,  0.00, 2.40)        0.0     0.0   319.9   224.0   128.0      70.0
FRONT_LEFT  (  1.30, -0.50, 2.40)      -55.0     0.0   319.9   224.0   128.0      70.0
FRONT_RIGHT (  1.30,  0.50, 2.40)       55.0     0.0   319.9   224.0   128.0      70.0
BACK        ( -1.50, -0.00, 2.40)      180.0     0.0   156.8   224.0   128.0     110.0
BACK_LEFT   ( -1.00, -0.50, 2.40)     -110.0     0.0   319.9   224.0   128.0      70.0
BACK_RIGHT  ( -1.00,  0.50, 2.40)      110.0     0.0   319.9   224.0   128.0      70.0

解读: yaw=0 朝正前,yaw<0 朝左,yaw>0 朝右,±180 朝后;cx≈W/2、cy≈H/2 说明内参缩放正确

========================================================================
STEP 2  BEV 网格坐标
========================================================================
coords.shape = (16384, 2)   (128×128 个格子,每个存 (x, y))
扁平索引 i  ↔  (行, 列) = divmod(i, bev)
  coords[    0] = ( 51.20, -51.20)   行   0 列   0
  coords[    1] = ( 51.20, -50.39)   行   0 列   1
  coords[  127] = ( 51.20,  51.20)   行   0 列 127
  coords[  128] = ( 50.39, -51.20)   行   1 列   0
  coords[ 8256] = ( -0.40,   0.40)   行  64 列  64
  coords[16383] = (-51.20,  51.20)   行 127 列 127
格子边长 ≈ 0.806 m

========================================================================
STEP 3  追踪一根柱子:格子 (20.0, 5.0)
========================================================================
最近的格子: 索引 5062 (行 39, 列 70),中心 = (19.75, 5.24)
柱子上的 4 个点 (x, y, z):
[[19.75  5.24 -2.  ]
 [19.75  5.24  0.  ]
 [19.75  5.24  2.  ]
 [19.75  5.24  4.  ]]

相机              z       u·d       v·d     d(深度)        u        v  有效?
FRONT        -2.0    5765.6    3766.5     18.25    315.8    206.3  ✓
FRONT         0.0    5765.6    3116.5     18.25    315.8    170.7  ✓
FRONT         2.0    5765.6    2466.5     18.25    315.8    135.1  ✓
FRONT         4.0    5765.6    1816.6     18.25    315.8     99.5  ✓
FRONT_LEFT   -2.0    7207.0    2182.9      5.88   1225.2    371.1  ✗ 落在图像外
FRONT_LEFT    0.0    7207.0    1532.9      5.88   1225.2    260.6  ✗ 落在图像外
FRONT_LEFT    2.0    7207.0     882.9      5.88   1225.2    150.1  ✗ 落在图像外
FRONT_LEFT    4.0    7207.0     233.0      5.88   1225.2     39.6  ✗ 落在图像外
FRONT_RIGHT  -2.0    -725.1    3281.9     14.47    -50.1    226.8  ✗ 落在图像外
FRONT_RIGHT   0.0    -725.1    2631.9     14.47    -50.1    181.9  ✗ 落在图像外
FRONT_RIGHT   2.0    -725.1    1982.0     14.47    -50.1    137.0  ✗ 落在图像外
FRONT_RIGHT   4.0    -725.1    1332.0     14.47    -50.1     92.1  ✗ 落在图像外
BACK         -2.0   -5583.0   -2019.5    -21.25        —        —  ✗ 在相机背后(d≤0)
BACK          0.0   -5583.0   -2338.1    -21.25        —        —  ✗ 在相机背后(d≤0)
BACK          2.0   -5583.0   -2656.8    -21.25        —        —  ✗ 在相机背后(d≤0)
BACK          4.0   -5583.0   -2975.5    -21.25        —        —  ✗ 在相机背后(d≤0)
BACK_LEFT    -2.0    2812.4    -169.2    -12.49        —        —  ✗ 在相机背后(d≤0)
BACK_LEFT     0.0    2812.4    -819.2    -12.49        —        —  ✗ 在相机背后(d≤0)
BACK_LEFT     2.0    2812.4   -1469.1    -12.49        —        —  ✗ 在相机背后(d≤0)
BACK_LEFT     4.0    2812.4   -2119.1    -12.49        —        —  ✗ 在相机背后(d≤0)
BACK_RIGHT   -2.0   -7349.9    1091.6     -2.64        —        —  ✗ 在相机背后(d≤0)
BACK_RIGHT    0.0   -7349.9     441.6     -2.64        —        —  ✗ 在相机背后(d≤0)
BACK_RIGHT    2.0   -7349.9    -208.4     -2.64        —        —  ✗ 在相机背后(d≤0)
BACK_RIGHT    4.0   -7349.9    -858.3     -2.64        —        —  ✗ 在相机背后(d≤0)

→ 只要某相机里 4 个点有一个 ✓,就说这个格子被该相机"覆盖"

========================================================================
STEP 4  全网格覆盖 cov[相机, 格子]
========================================================================
pts   (65536, 3)  →  q (6, 65536, 4)  →  valid (6, 16384, 4)  →  cov (6, 16384)
自检: STEP 3 那个格子的 cov[:, 5062] = [1 0 0 0 0 0]  (应与上表每个相机是否有 ✓ 一致)
  FRONT        覆盖  16.5% 的格子
  FRONT_LEFT   覆盖  19.7% 的格子
  FRONT_RIGHT  覆盖  19.7% 的格子
  BACK         覆盖  31.0% 的格子
  BACK_LEFT    覆盖  19.1% 的格子
  BACK_RIGHT   覆盖  19.1% 的格子
  被 0 个相机看到:   0.3%   ← 盲区(白色)
  被 1 个相机看到:  74.3%
  被 2 个相机看到:  25.4%   ← 重叠区(深色)

========================================================================
STEP 5  cov → RGB 覆盖图
========================================================================
rgb (16384, 3) → reshape → cov_img (128, 128, 3)
cov_img[0, 0]   (左上角) 对应 coords[0]   = [ 51.2 -51.2]  前方最远、最左
cov_img[-1, -1] (右下角) 对应 coords[-1]  = [-51.2  51.2]  后方最远、最右
imshow(..., extent=[-pc, pc, -pc, pc]) 默认 origin="upper":第 0 行画在最上面 (x=+pc),第 0 列画在最左边 (y=-pc)

========================================================================
STEP 6  GT 框 #7 → BEV 4 个角点
========================================================================
box = (x=10.30, y=-6.92, z=2.11, l=10.27, w=3.94, h=4.25, yaw=3.134 rad = 179.5°)  类别 0

6a 框自己的坐标系(车头朝 +x,中心在原点):
   角点0 (前右) = (  5.14,   1.97)
   角点1 (前左) = (  5.14,  -1.97)
   角点2 (后左) = ( -5.14,  -1.97)
   角点3 (后右) = ( -5.14,   1.97)

6b 旋转矩阵 R(yaw) =
[[-1.   -0.01]
 [ 0.01 -1.  ]]
   rotated = local @ R.T
[[-5.15 -1.93]
 [-5.12  2.01]
 [ 5.15  1.93]
 [ 5.12 -2.01]]

6c 平移到 (x, y) = (10.30, -6.92):  world = rotated + [x, y]
[[ 5.15 -8.85]
 [ 5.18 -4.91]
 [15.45 -4.99]
 [15.42 -8.93]]

========================================================================
STEP 7  加上高度 → 8 个 3D 角点
========================================================================
z 是中心高度 → 底面 z0 = -0.02,顶面 = 4.24
   角点0 = (   5.15,   -8.85, -0.02)   底面 车头
   角点1 = (   5.18,   -4.91, -0.02)   底面 车头
   角点2 = (  15.45,   -4.99, -0.02)   底面 车尾
   角点3 = (  15.42,   -8.93, -0.02)   底面 车尾
   角点4 = (   5.15,   -8.85,  4.24)   顶面 车头
   角点5 = (   5.18,   -4.91,  4.24)   顶面 车头
   角点6 = (  15.45,   -4.99,  4.24)   顶面 车尾
   角点7 = (  15.42,   -8.93,  4.24)   顶面 车尾

========================================================================
STEP 8  8 个角点投影到 6 个相机
========================================================================

[FRONT]  → 画(4/8 个角点在图像内)
   角点0: d=   3.65  u=  -552.4  v=   343.4  图外
   角点1: d=   3.68  u=  -202.7  v=   341.6  图外
   角点2: d=  13.95  u=   109.6  v=   184.3  ✓
   角点3: d=  13.92  u=    18.7  v=   184.4  ✓
   角点4: d=   3.65  u=  -552.4  v=   -35.6  图外
   角点5: d=   3.68  u=  -202.7  v=   -34.2  图外
   角点6: d=  13.95  u=   109.6  v=    85.2  ✓
   角点7: d=  13.92  u=    18.7  v=    85.1  ✓

[FRONT_LEFT]  → 画(5/8 个角点在图像内)
   角点0: d=   9.05  u=   166.1  v=   214.8  ✓
   角点1: d=   5.83  u=   259.6  v=   262.7  图外
   角点2: d=  11.79  u=   468.6  v=   194.6  图外
   角点3: d=  15.01  u=   367.4  v=   180.4  ✓
   角点4: d=   9.05  u=   166.1  v=    62.1  ✓
   角点5: d=   5.83  u=   259.6  v=    25.8  ✓
   角点6: d=  11.79  u=   468.6  v=    77.4  图外
   角点7: d=  15.01  u=   367.4  v=    88.3  ✓

[FRONT_RIGHT]  → 不画(0/8 个角点在图像内)
   角点0: d=  -5.45  u=-394520362.4  v=8766351.0  背后
   角点1: d=  -2.20  u=-250214459.7  v=50352739.4  背后
   角点2: d=   3.62  u= -1078.7  v=   345.0  图外
   角点3: d=   0.37  u=-14412.0  v=  2245.3  背后
   角点4: d=  -5.45  u=-394520362.4  v=-129448912.5  背后
   角点5: d=  -2.20  u=-250214459.7  v=-87862524.2  背后
   角点6: d=   3.62  u= -1078.7  v=   -36.8  图外
   角点7: d=   0.37  u=-14412.0  v= -1479.5  背后

[BACK]  → 不画(0/8 个角点在图像内)

[BACK_LEFT]  → 不画(0/8 个角点在图像内)
   角点0: d=   5.74  u=   704.7  v=   264.8  图外
   角点1: d=   2.03  u=  1377.9  v=   515.5  图外
   角点2: d=  -1.41  u=512134519.5  v=60544815.5  背后
   角点3: d=   2.31  u=  2761.1  v=   468.2  图外
   角点4: d=   5.74  u=   704.7  v=    24.2  图外
   角点5: d=   2.03  u=  1377.9  v=  -166.2  图外
   角点6: d=  -1.41  u=512134519.5  v=-77670448.0  背后
   角点7: d=   2.31  u=  2761.1  v=  -130.3  图外

[BACK_RIGHT]  → 不画(0/8 个角点在图像内)

规则: ① 只要有 1 个角点在图内且 d>1m,这个相机就画这个框
      ② 每条线两端 d 都 >1m 才画(太近/背后的点透视后会飞到天边)
      ③ 线段伸出图像的部分由 set_xlim/set_ylim 自动裁掉

========================================================================
STEP 9  全部 GT 框 → 覆盖图 + 6 路相机
========================================================================

全部完成,图片在 /home/leoking/carla/work/courses/M2/2.3/learn_real/
(ad) leoking@leoking-desktop:~/carla/work/courses/M2/2.3$
下边是生成的图片:
为者常成,行者常至
自由转载-非商用-非衍生-保持署名(创意共享3.0许可证)


